Un vistazo en 33 segundos
- El encarecimiento de la memoria ya no es otro ciclo de escasez de semiconductores: la IA está decidiendo qué se fabrica en cada oblea.
- Un módulo RDIMM DDR5 de 64 GB pasó de unos 390 euros en el cuarto trimestre de 2025 a más de 775 en el primero de 2026, y TrendForce prevé otro 13-18 % trimestral en el tercero de 2026.
- Encadenando los tres últimos trimestres, la memoria de servidor se ha multiplicado por entre 3,4 y 3,8 veces.
- El problema se alarga hasta 2027: la oferta de bits RDIMM crecería solo un 15-20 % interanual y las fábricas nuevas no aportan volumen relevante hasta la segunda mitad de ese año.
- Comprar siempre la generación más reciente deja de ser automáticamente lo más eficiente, y las configuraciones de 1 TB y 1,5 TB de RAM son las que más notan la subida.
- Reducir, rediseñar y reutilizar hardware pasa a ser una decisión de arquitectura, no solo de ahorro.
Durante años dimos por hecho que cada renovación de hardware traía más memoria y más almacenamiento por menos dinero. Esa curva ha dejado de comportarse como esperábamos, y no por un cuello de botella pasajero en una fábrica concreta.
La expansión de la inteligencia artificial está cambiando dónde colocan los fabricantes su capacidad productiva y qué productos tienen prioridad. HBM, memoria de servidor y almacenamiento empresarial compiten por unas fábricas que no pueden crecer al ritmo de la demanda, y esa presión acaba llegando a la RAM, a los SSD y, al final del recorrido, al precio de desplegar infraestructura.
Para quien administra sistemas o firma presupuestos de infraestructura, la consecuencia es incómoda: el componente que siempre fue la variable fácil de subir se ha convertido en el que más pesa en la factura.
Cuánto ha subido de verdad la memoria de servidor
Conviene poner cifras antes de teorizar. Estos son los datos de subida trimestral de precios contractuales de DRAM de servidor recogidos por TrendForce y por las casas de análisis que siguen el mercado:
| Trimestre | Subida de precio contractual (QoQ) | Contexto |
|---|
| 1T 2026 | +93 % a +98 % | El trimestre que rompió el mercado |
| 2T 2026 | +55 % a +63 % | Sigue el tirón, con LTA conteniendo parte |
| 3T 2026 | +13 % a +18 % | Se modera el ritmo, no el nivel |
| 4T 2026 | Al alza | ADATA anuncia entre un 20 % y un 30 % |
Encadenados, esos porcentajes dan un factor de entre 3,4 y 3,8 desde finales de 2025. En dinero contante, y esto es lo que acaba en el presupuesto:
| Módulo RDIMM DDR5 de 64 GB | Precio unitario aproximado |
|---|
| 4T 2025 | 390 € (450 $) |
| 1T 2026 | más de 775 € (900 $) |
| 4T 2026, proyección de Citi | unos 1.370 € (1.586 $) |
Las fuentes publican en dólares; la conversión va al cambio de mediados de agosto de 2026, alrededor de 1,157 dólares por euro. Y en mercado abierto, fuera de contrato, los precios han llegado a triplicar esa referencia.
Hay un matiz importante en el dato del tercer trimestre. Que la subida se modere al 13-18 % no significa que los precios bajen, sino que suben más despacio desde un nivel que ya es tres veces el de hace un año. Y TrendForce advierte de que buena parte de esa moderación viene de los acuerdos a largo plazo (LTA) que tapan el golpe a los grandes clientes: quien compra fuera de LTA paga el precio real del mercado.
La IA no compra solo GPU: también absorbe memoria
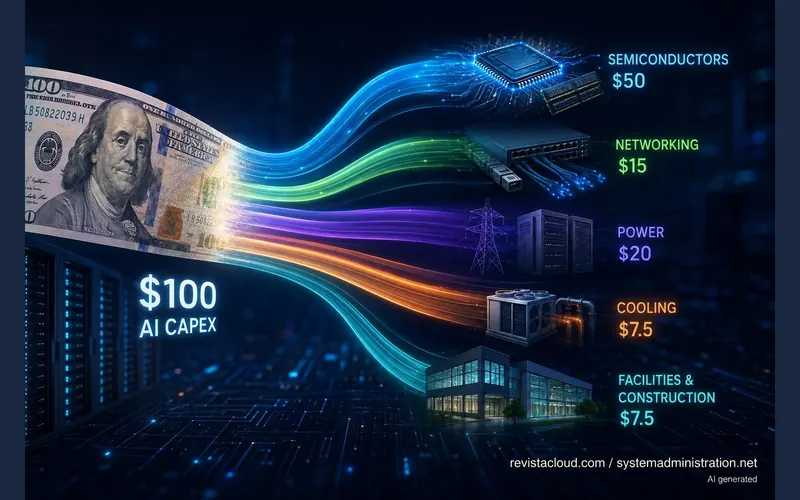
Cuando se habla del coste de la infraestructura de IA, las GPU se llevan casi toda la atención. Pero una GPU no trabaja sola: los aceleradores necesitan cantidades enormes de memoria de gran ancho de banda, y los servidores que los rodean llevan además procesadores, DRAM convencional, NVMe, red de alta velocidad y sistemas de alimentación y refrigeración.
La explosión de la HBM tiene una característica que explica casi todo lo demás: fabricarla consume mucha más capacidad productiva que fabricar DRAM convencional. TrendForce señala que requiere bastantes más obleas por bit útil, así que cada punto de capacidad que se mueve hacia HBM resta capacidad disponible para el resto de segmentos. Y los fabricantes tienen un incentivo económico evidente para priorizar el producto de mayor margen.
No es que “la IA compre toda la RAM”. Es que los fabricantes están reorganizando procesos, inversiones y capacidad alrededor de HBM y productos de servidor, y los demás mercados reciben el efecto secundario. Lo mismo que ya vimos en la carrera por la litografía EUV: el cuello de botella real está aguas arriba, en las obleas, no en el catálogo del distribuidor.
| Componente | Qué está ocurriendo | Consecuencia para infraestructura |
|---|
| HBM | Fuerte crecimiento por aceleradores de IA | Absorbe capacidad DRAM del resto |
| DRAM de servidor | Demanda elevada y oferta ajustada | Servidores con mucha RAM más caros |
| DDR4 | Menor prioridad productiva | Lo antiguo no baja necesariamente de precio |
| DDR5 | Presión de servidores y plataformas nuevas | Renovar generación cuesta más |
| SSD empresarial | Crece con centros de datos e IA | Almacenamiento de servidor tensionado |
| NAND de consumo | Situación menos ajustada a medio plazo | Podría relajarse antes que la DRAM |
Hay una diferencia relevante entre DRAM y NAND. TrendForce espera que la NAND Flash recupere una situación de oferta más holgada durante la segunda mitad de 2027, con capacidad nueva entrando y una demanda de electrónica de consumo floja. Para la DRAM el escenario es peor: la consultora estima un ratio de suficiencia de entre el -1 % y el -2 % en 2026 y ve la brecha ampliándose en 2027, con la oferta de bits RDIMM creciendo solo un 15-20 % interanual mientras las plataformas nuevas piden más memoria por socket.
O sea, que RAM y SSD dejarán de moverse a la vez. Asumir que suben o bajan al mismo ritmo lleva a presupuestos equivocados.
De dónde salen los 256, 512, 768 GB, 1 TB y 1,5 TB del catálogo
Las capacidades que aparecen en las fichas de servidores dedicados no son cifras de marketing. Salen de multiplicar los canales de memoria del procesador por la capacidad del módulo que pongas en cada canal, y por eso los saltos son los que son.
Una plataforma AMD EPYC moderna tiene 12 canales DDR5 por socket; un Xeon lleva 8 o 12 según la serie. En un servidor de dos sockets con un módulo por canal eso son 16 o 24 ranuras, y de ahí sale la aritmética:
| Ranuras pobladas | Con DIMM de 16 GB | de 32 GB | de 64 GB | de 96 GB | de 128 GB |
|---|
| 16 (2 × 8 canales) | 256 GB | 512 GB | 1 TB | 1,5 TB | 2 TB |
| 24 (2 × 12 canales) | 384 GB | 768 GB | 1,5 TB | 2,3 TB | 3 TB |
Aquí está la trampa del momento actual. Para llegar a 1 TB o 1,5 TB hay dos caminos: poner muchos módulos pequeños o pocos módulos grandes, y el precio por gigabyte no es el mismo. Los DIMM de alta capacidad, los de 96 y 128 GB, cargan una prima que se ha disparado justo porque son los que se pelean con los servidores de IA.
La prueba está en el propio informe de TrendForce: los grandes proveedores cloud están cambiando módulos de 96 y 128 GB por otros de 32 y 64 GB para contener el coste. Es un movimiento revelador, porque significa aceptar más ranuras ocupadas y menos margen de ampliación futura a cambio de un precio por gigabyte más razonable.
Puesto en euros se entiende mejor lo que está en juego. Un nodo de 1,5 TB montado con 24 módulos de 64 GB costaba unos 9.400 € solo de memoria a finales de 2025; con los precios del primer trimestre de 2026 se va por encima de los 18.600 €, y si se cumple la proyección de Citi para el cierre de año rondaría los 32.900 €. El mismo servidor, la misma memoria, tres veces y media la factura.
Para quien contrata infraestructura la lectura práctica es doble. Si tu carga cabe en 768 GB, pedir 1 TB “por si acaso” puede empujarte al escalón de módulos caros sin ganar nada. Y si necesitas de verdad 1,5 TB, sale mejor una plataforma de 12 canales por socket con DIMM de 64 GB que una de 8 canales obligada a montar módulos de 96 GB.
El servidor más nuevo ya no es siempre el más barato
Esto obliga a recuperar una pregunta que parecía tener respuesta obvia: ¿hay que ir siempre a la última generación disponible?
Por rendimiento absoluto, seguramente sí. Por dinero, depende mucho más de la carga de lo que solemos admitir. Una plataforma moderna ofrece mejor rendimiento por núcleo, más ancho de banda de memoria, PCIe más rápido y mejor eficiencia energética, pero una aplicación que necesita 512 GB de RAM y poca CPU puede funcionar perfectamente sobre la generación anterior.
Piensa en servidores de bases de datos, cachés grandes, ciertos nodos de virtualización, almacenamiento o aplicaciones empresariales heredadas que mantienen conjuntos de datos enteros en memoria. Para ellas importa menos el último punto de rendimiento que tener suficiente RAM, y ahí el mercado actual produce situaciones que hace dos años sonarían raras: mantener servidores DDR4 unos años más puede salir más a cuenta que migrarlos ya a DDR5.
Eso no convierte al hardware antiguo en buena compra por defecto. Hay que meter en la ecuación el consumo eléctrico, que en un rack denso pesa y mucho (lo desarrollamos al hablar del PUE y el coste oculto de la energía), la disponibilidad de repuestos, el soporte del fabricante, la densidad de rack y el riesgo operativo de una plataforma sin actualizaciones de firmware. Pero jubilar un servidor solo porque ha salido una generación nueva tampoco tiene mucho sentido con estos precios.
El coste real aparece cuando falta RAM
Hay una tentación peligrosa cuando la memoria se encarece: dimensionar demasiado justo. Suele salir caro.
La diferencia entre acceder a DRAM y acceder a almacenamiento se mide en órdenes de magnitud. Un NVMe moderno es rapidísimo comparado con un disco, y sigue siendo mucho más lento que la memoria principal. Cuando una base de datos, una máquina virtual o una aplicación empieza a tirar de swap de forma continua, el problema deja de ser lo que costó el DIMM y pasa a ser el tiempo de respuesta que ven tus usuarios.
Por eso reducir memoria no consiste en poner menos módulos y ya está. La pregunta correcta es cuánta memoria necesita de verdad cada carga y por qué, y esa se responde midiendo.
Muchas infraestructuras arrastran máquinas virtuales sobredimensionadas desde hace años. Una VM recibió 32 GB porque parecía una cifra razonable en 2021 y sigue con 32 GB aunque use nueve de media. Multiplicado por doscientas máquinas, ese margen son varios servidores enteros de memoria comprada y sin usar.
La virtualización permite trabajar ese margen con ballooning y asignación dinámica, siempre conociendo el comportamiento de las aplicaciones. Los contenedores recortan otra parte del overhead, al ahorrarse un sistema operativo completo por servicio, aunque no todo encaja en un contenedor: la frontera la repasamos en LXC frente a máquinas virtuales.
Las bases de datos merecen un análisis aparte. Recortarles los buffers de forma agresiva traslada la presión al almacenamiento y empeora la latencia, así que ahí la salida suele pasar por diseñar bien las capas de disco antes que por quitar RAM: un special vdev o un L2ARC bien planteado absorben parte del trabajo que hoy hace la memoria.
Optimizar RAM significa medir antes de recortar. Sin datos de utilización real, cualquier ajuste es una apuesta.
Reducir, rediseñar y reutilizar
Las tres erres de toda la vida se trasladan bastante bien al centro de datos, con matices.
Reducir es encontrar dónde se desperdicia memoria. Rightsizing de máquinas virtuales, límites correctos en contenedores, revisión de cachés, compresión y retirada de servicios que ya no usa nadie liberan cantidades sorprendentes de RAM. Casi siempre hay más margen del que el equipo cree, y hasta que no se mide no aparece.
Rediseñar es cuestionar la arquitectura. Diez servidores al 20 % de utilización pueden salir más caros que consolidar las mismas cargas en menos nodos con más capacidad, sobre todo ahora que cada zócalo de memoria cuesta lo que cuesta. La consolidación tiene límites evidentes: alta disponibilidad, dominios de fallo, ventanas de mantenimiento y recuperación ante desastres obligan a mantener redundancia, y un único servidor enorme no sustituye a un clúster. Pero hay muchas plataformas donde CPU y memoria están infrautilizadas simplemente porque el diseño original nunca se revisó. Qué carga pide hierro dedicado y cuál se virtualiza es justo lo que analizamos en bare metal o virtualización, según la carga.
Reutilizar es alargar la vida útil de una generación que sigue cumpliendo los requisitos de rendimiento, seguridad y soporte. Y aquí está una de las consecuencias menos comentadas de esta crisis: durante años la industria ha equiparado modernizar con sustituir. La presión sobre la DRAM obliga a separar las dos cosas.
Modernizar también es virtualizar mejor, consolidar cargas, actualizar el software, automatizar operaciones o mover al hardware nuevo únicamente aquellas aplicaciones que se benefician de verdad. El resto puede esperar a que el mercado se relaje.
El precio de la infraestructura acaba absorbiendo la subida
Los proveedores no estamos al margen de este mercado. Un servidor dedicado, una plataforma de cloud privado o un clúster de virtualización llevan CPU, RAM, SSD, tarjetas de red y repuestos, y si sube el coste de adquisición de los equipos, mantener los mismos precios indefinidamente no se sostiene.
El efecto se nota especialmente en las configuraciones con 384, 512, 768 GB, 1 TB o 1,5 TB de RAM, que son precisamente las que piden las plataformas de virtualización, las bases de datos grandes y los nodos de inferencia. Son las que más memoria llevan por chasis y, por tanto, las que más se han encarecido en términos absolutos.
Y hay un segundo efecto, menos visible: el coste de reposición. Un proveedor puede seguir operando servidores comprados hace tres años a precios de entonces, pero cuando toca ampliar un clúster o sustituir un nodo, lo hace a precio de hoy. El coste histórico del hardware deja de representar el coste real de prestar el servicio en los próximos años, y eso tarde o temprano aparece en las tarifas.
Esto también explica por qué gana peso el modelo de prolongar la vida de equipo empresarial perfectamente funcional en lugar de renovar por calendario. No es una anomalía, es la respuesta razonable a un mercado donde el silicio ha cambiado de precio. Y encaja con lo que ya contamos sobre la repatriación de cargas desde la nube pública: la aritmética del hardware propio o dedicado se ha vuelto más sensible al ciclo de la memoria de lo que era.
Cómo lo planteamos nosotros
Cuando alguien nos pide un servidor dedicado o un cloud privado sobre Proxmox, la primera conversación ya no empieza por el procesador. Empieza por la memoria: cuánta necesita realmente la carga, cómo va a crecer y en qué escalón de módulos cae esa cifra.
De ahí salen decisiones concretas. Si una plataforma necesita 1,5 TB, hay diferencia real de precio entre montarla con 24 módulos de 64 GB o con 16 de 96, y esa diferencia conviene saberla antes de firmar. Si tu carga es de inferencia con GPU, la memoria del host importa tanto como la del acelerador para alimentar el pipeline sin cuellos de botella, algo que se ve claro al montar passthrough de GPU en Proxmox. Y si lo que tienes es un parque virtualizado con años encima, muchas veces el mejor euro invertido no es un servidor nuevo, sino una revisión seria de cuánta RAM está asignada y sin usar.
Trabajamos con hardware dedicado en centros de datos en España, con configuraciones que van desde 256 GB hasta 1,5 TB de RAM por nodo, y dimensionamos según medidas reales, no según el catálogo. Si quieres ver cómo queda el número completo, en cuánto cuesta un cloud privado desglosamos las partidas.
La memoria empieza a decidir la arquitectura
La situación puede cambiar. Los fabricantes están ampliando capacidad y las plantas previstas para 2027 irán aportando producción, aunque TrendForce avisa de que una contribución realmente relevante podría retrasarse hasta 2028. Y DRAM y NAND van a seguir caminos distintos, así que no toca asumir que RAM y SSD suban al mismo ritmo.
Pero la señal para quien diseña infraestructura ya está sobre la mesa. Durante años dimensionábamos empezando por CPU y almacenamiento, con la memoria como variable barata que siempre se podía ampliar. La IA ha roto ese supuesto.
En los próximos ciclos de renovación, la primera pregunta probablemente no sea qué procesador comprar, sino cuánta memoria necesita de verdad la aplicación y cuánto va a costar mantenerla ahí durante los próximos cinco años.
Preguntas frecuentes
¿Por qué está subiendo tanto el precio de la RAM?
Porque la demanda de servidores de IA dispara el consumo de HBM y de memoria de servidor, y los fabricantes destinan a esos productos una capacidad de fábrica que no crece al mismo ritmo. TrendForce prevé que la oferta de DRAM siga ajustada durante todo 2027, con la oferta de bits RDIMM creciendo solo un 15-20 % interanual.
¿La IA también encarece los SSD?
La expansión de los centros de datos está elevando la demanda de SSD empresariales, pero el mercado NAND funciona distinto al de la DRAM. TrendForce espera que la entrada de capacidad nueva relaje la oferta de NAND durante la segunda mitad de 2027, así que es probable que el almacenamiento se normalice antes que la memoria.
¿Tiene sentido seguir usando servidores DDR4?
Puede tenerlo si su rendimiento, consumo, soporte y fiabilidad siguen encajando con la carga. En aplicaciones donde importa tener mucha memoria más que la CPU más reciente, alargar su vida reduce bastante el coste. La cuenta cambia si el consumo eléctrico o la falta de soporte se comen el ahorro.
¿Cuánto cuesta hoy un servidor de 1 TB o 1,5 TB de RAM?
Depende de con qué módulos se monte. Solo la memoria de un nodo de 1,5 TB con 24 DIMM de 64 GB anda por los 18.600 € a precios de 2026, frente a unos 9.400 € a finales de 2025, y montar esa misma capacidad con 16 módulos de 96 GB sale distinto porque los de alta capacidad cargan prima. Por eso conviene decidir la plataforma y el número de canales antes que la cifra redonda de memoria.
¿Cómo puede una empresa reducir el coste de sus servidores?
Empezando por medir la utilización real de RAM, CPU y almacenamiento. Ajustar máquinas virtuales sobredimensionadas, consolidar cargas, usar contenedores donde encajen y alargar el hardware que todavía cumple evita comprar capacidad nueva en el peor momento del ciclo.
Fuentes
- TrendForce, Diverging Memory Market Outlook in 2027 as DRAM Supply Remains Tight While NAND Flash Supply Conditions Ease, 30/07/2026.
- TrendForce, Long-Term Agreements Cap Price Increases; Server DRAM Contract Prices Expected to Rise 13-18% QoQ in 3Q26, 09/07/2026.
- TrendForce, AI Server Demand Continues to Support Memory Prices in 3Q26, 03/07/2026.
- TrendForce, Server DIMM Price Jul. 2026, 31/07/2026.
- Citi, proyección de precio unitario de RDIMM DDR5 de 64 GB para 2026, recogida por medios del sector en mayo de 2026.
- Conversión a euros al tipo de cambio de referencia de mediados de agosto de 2026 (1 € ≈ 1,157 $). Las cifras originales de TrendForce y Citi están en dólares.
¿Estás dimensionando servidores y no sabes si te va a hacer falta 512 GB, 1 TB o 1,5 TB de RAM? Te ayudamos a medir la carga real y a elegir la plataforma que menos memoria desperdicia. Echa un vistazo a nuestros servidores dedicados o cuéntanos tu caso.