Usamos cookies técnicas y, si lo aceptas, de analítica (Google Analytics 4) para
mejorar el sitio. Hasta entonces no se instalan cookies de analítica.
Más información en la política de cookies.
Con dos nodos y sin QDevice, cortar uno deja al otro sin quórum. En nuestra prueba, a los 15 segundos /etc/pve estaba en solo lectura y Proxmox respondía «no quorum!» a cualquier cambio de configuración.
Con el QDevice, el mismo corte no tuvo efecto en el quórum. El nodo que quedó en pie pasó de 3 a 2 votos de 3 y siguió escribiendo en /etc/pve sin perder el quórum en ningún momento.
Si la red entre los nodos se parte, el QDevice decide. Le dio su voto al nodo con el ID más bajo y dejó al otro bloqueado. Es justo lo que evita la situación en que cada mitad cree que es la buena.
El QDevice no es un punto único de fallo, pero tampoco sobra. Con él apagado el clúster sigue funcionando, aunque sin margen: al cortar después un nodo, el otro perdió el quórum en unos diez segundos.
El fallo más habitual es el de SSH.pvecm qdevice setup entra como root en el QDevice, y una Debian recién instalada no deja entrar a root con contraseña. Mejor copiar la clave antes que abrir el acceso.
Todo el clúster tiene que estar en línea para añadir o quitar el QDevice. Con un nodo caído, pvecm se niega.
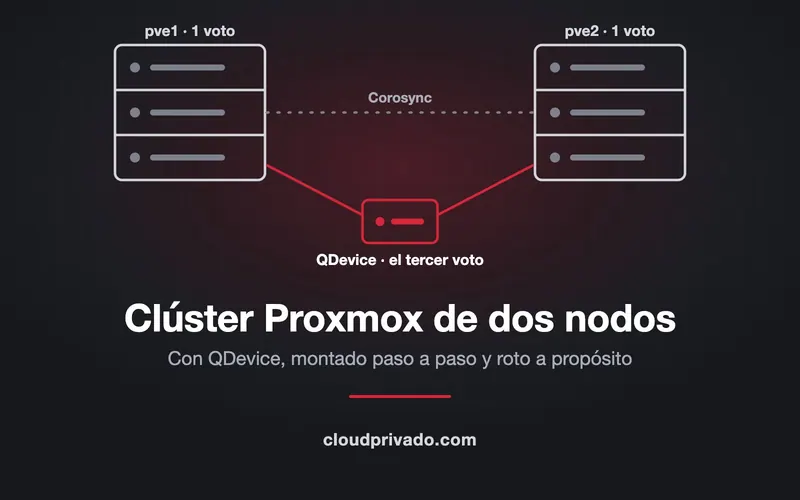
Un clúster Proxmox de dos nodos es una de las configuraciones más comunes en empresas pequeñas, delegaciones y laboratorios. También es de las que más sustos dan cuando falla, porque dos votos no tienen desempate. Ya explicamos por qué tres es el mínimo aritmético para el quórum y cómo replicar con ZFS entre dos nodos. Aquí vamos a la parte práctica: montar el clúster desde cero, añadirle el tercer voto con un QDevice y comprobar qué pasa cuando las cosas se rompen.
Las guías que circulan suelen terminar cuando pvecm status muestra tres votos. Nosotros quisimos ver los fallos, así que, después de montarlo, apagamos nodos de golpe, paramos el QDevice y partimos la red.
El laboratorio
Todo corre en tres máquinas virtuales Debian 13.7 arm64 sobre un Mac con Apple Silicon, en una red privada común:
Máquina
Papel
Dirección
Software
pve1
Nodo 1
192.168.104.1
Proxmox VE 9.2 arm64 (pve-manager 9.2.29), Corosync 3.2.0
pve2
Nodo 2
192.168.104.3
El mismo
qdevice
Tercer voto
192.168.104.4
Debian 13 con corosync-qnetd 3.0.3, 1 GB de RAM
Proxmox VE se instaló sobre Debian siguiendo el procedimiento oficial, con el repositorio pve-no-subscription para arm64, que existe desde agosto con la primera versión oficial de Proxmox para ARM. Dos avisos para no sacar conclusiones de más. Los nodos arrancan con el núcleo de Debian, no con el de Proxmox, y no se ejecutaron máquinas virtuales, porque para medir el quórum no hacen falta. Además, Proxmox certifica arm64 en ARMv9 y este Mac no lo es: vale para un laboratorio, no para producción.
Un dato de versiones que conviene saber: la última versión de Corosync, la 3.2.0, salió el 27 de octubre y el repositorio de Proxmox ya la distribuye. El QDevice, en cambio, va con la corosync-qdevice 3.0.3 de Debian, aunque el proyecto publicó la 3.0.5 el 12 de noviembre.
Antes de empezar
Tres comprobaciones que ahorran problemas:
La misma versión de Proxmox en los dos nodos y los dos actualizados. Proxmox no recomienda mezclar versiones en un clúster, salvo durante una actualización escalonada.
Nombres e IP fijos. El nombre de cada nodo debe resolver a su IP real en /etc/hosts. Cambiarlo después es delicado, y cambiar la IP, también: lo contamos en el post sobre la red de Corosync.
Una red para Corosync que se pueda definir en el asistente. Aquí nos encontramos el primer obstáculo, y no viene en ninguna guía.
Si instalas Proxmox sobre una Debian que gestiona la red con netplan, NetworkManager o similar, la IP funciona, pero no aparece en /etc/network/interfaces, que es de donde la lee Proxmox. El resultado es que en el diálogo de crear el clúster, el desplegable de la red sale vacío y en rojo, y el botón Create se queda desactivado. Con el instalador ISO no pasa, porque deja la red en ese fichero. Si te ocurre, declara la interfaz allí, con la misma dirección que ya tiene.
Paso 1: crear el clúster en el primer nodo
En la interfaz web de pve1: Datacenter → Cluster → Create Cluster. Se pone un nombre (aquí, lab), se elige la red de Corosync en Link 0 y se pulsa Create.
El nombre no se puede cambiar después sin rehacer el clúster, así que conviene pensarlo. Con Add se añade un segundo enlace de Corosync, que actúa como respaldo si cae el primero. En producción es muy recomendable: dos enlaces en conexiones físicas distintas.
La tarea tarda un par de segundos: genera la clave de autenticación de Corosync, escribe /etc/pve/corosync.conf y reinicia los servicios. Desde la consola sería:
pvecm create lab --link0 192.168.104.1
Después, en la misma pantalla, el botón Join Information muestra lo que necesita el segundo nodo: dirección, huella del certificado y un bloque codificado que lo resume todo.
Paso 2: unir el segundo nodo
En la interfaz de pve2: Datacenter → Cluster → Join Cluster. Se pega la información, se escribe la contraseña de root de pve1 y se comprueba la red del enlace. Al pegar el bloque, la dirección del otro nodo y la huella se rellenan solas.
Al pulsar Join ‘lab’, la sesión web del nodo que se une se corta, porque cambia su certificado. Es normal: se vuelve a entrar y ya forma parte del clúster. Desde la consola de pve2 sería pvecm add 192.168.104.1.
El nodo que se une no debe tener máquinas virtuales. Proxmox lo exige para evitar conflictos de identificadores, porque su configuración local se sustituye por la del clúster.
Con los dos dentro, pvecm status muestra lo esperado: dos votos esperados, dos presentes y un quórum de dos.
Ese «quórum de dos» es el problema. Para tener mayoría hacen falta los dos nodos.
Prueba 1: cortar un nodo sin QDevice
Apagamos pve2 de golpe, como si se fuera la corriente, y miramos pve1 quince segundos después.
Esto es lo que ocurrió:
/etc/pve pasó a solo lectura. Ni touch ni mkdir: «Permission denied».
Cualquier cambio de configuración falló con cfs-lock ... error: no quorum!. Esto incluye crear, arrancar o migrar máquinas, y tocar permisos o almacenamiento.
La alta disponibilidad quedó parada: No quorum on node 'pve1'!. Si pve2 hubiera tenido máquinas protegidas por HA, pve1 no las habría arrancado.
La interfaz web lo muestra claramente: estado en rojo y «Quorate: No».
Hay un matiz que muchas guías explican mal: las máquinas que ya estaban en marcha en pve1 siguen funcionando. Lo que se bloquea es el clúster, es decir, todo lo que pasa por /etc/pve. El riesgo de verdad aparece con alta disponibilidad activa: un nodo que pierde el quórum y tiene recursos de HA se reinicia solo por el watchdog a los 60 segundos, para no arriesgarse a arrancar dos veces la misma máquina. En dos nodos sin QDevice, eso significa que el nodo superviviente puede reiniciarse justo cuando más falta hace.
La salida de emergencia, y por qué es de emergencia
Con un nodo muerto y sin QDevice, se puede devolver la escritura al superviviente:
pvecm expected 1
En la prueba funcionó al momento: un voto esperado, quórum de uno y /etc/pve escribible. Al volver pve2, los votos esperados regresaron solos a dos. La documentación lo reserva para emergencias por una razón: si el otro nodo no está muerto, sino aislado, y alguien hace lo mismo allí, tienes dos clústeres que se creen el bueno.
Paso 3: preparar el QDevice
El QDevice es un pequeño servicio, corosync-qnetd, que corre en una máquina fuera del clúster y solo aporta un voto de desempate. No aloja máquinas ni datos. En nuestra VM ocupaba unos 13 MB de memoria y corría con un usuario sin privilegios, coroqnetd.
Dónde ponerlo importa más que en qué ponerlo. Un miniPC, una Raspberry Pi con Raspberry Pi OS o una VM pequeña en otra ubicación sirven, porque el paquete existe para cualquier Debian, incluida arm. Lo que no sirve es una máquina que caiga a la vez que uno de los nodos: misma regleta, mismo switch o, peor, una VM dentro del propio clúster. A diferencia de Corosync, el QDevice habla por TCP (puerto 5403) y no necesita baja latencia, así que puede estar en otra sede si hay conectividad.
En el QDevice:
apt install corosync-qnetd
En los dos nodos:
apt install corosync-qdevice
En Debian, el servicio corosync-qnetd queda activo al instalarlo, así que no hace falta el systemctl enable --now que repiten algunas guías, aunque tampoco hace daño. Y no hace falta tocar /etc/hosts en el QDevice: la configuración se hace por IP y nosotros no lo editamos en ningún momento.
El error de SSH que tumba la configuración
pvecm qdevice setup entra en el QDevice como root por SSH para copiar certificados. Antes lanza ssh-copy-id con la clave del nodo desde el que lo ejecutas. Dejamos el SSH del QDevice como queda en una Debian recién instalada, con PermitRootLogin prohibit-password, y esto es lo que pasó:
Hay dos soluciones. La documentación de Proxmox admite las dos, pero no son iguales.
La buena: copiar la clave antes. Desde la consola del QDevice, con tu usuario y sudo, añade el contenido de /root/.ssh/id_rsa.pub del nodo donde vas a lanzar el comando a /root/.ssh/authorized_keys. Así pvecm entra con la clave y nunca hace falta abrir el acceso de root con contraseña. Lo comprobamos: ssh-copy-id vio que la clave ya estaba («All keys were skipped») y la configuración terminó sin pedir nada.
La rápida: abrir la contraseña de root solo mientras dura el proceso. Mejor en un fichero aparte, que se borra al terminar, que editando sshd_config:
# En el QDevice, solo durante la configuraciónecho "PermitRootLogin yes" > /etc/ssh/sshd_config.d/99-qdevice-temporal.confsystemctl restart ssh# ... pvecm qdevice setup desde el nodo ...rm /etc/ssh/sshd_config.d/99-qdevice-temporal.confsystemctl restart ssh
Muchas guías dicen que hay que habilitar el login de root y no explican que luego hay que quitarlo. Se queda abierto en una máquina que, por definición, tiene que ser accesible desde la red del clúster.
Paso 4: añadir el QDevice al clúster
Desde un solo nodo, con los dos en línea:
pvecm qdevice setup 192.168.104.4
En el laboratorio tardó 4,8 segundos. Por orden, el comando inicializa la autoridad de certificación en el QDevice, copia su certificado a cada nodo, genera y firma el certificado del clúster, lo importa en los dos nodos, añade el dispositivo a corosync.conf y arranca corosync-qdevice en ambos. Termina con un «Done». Por el camino aparece un aviso de que la base de certificados del QDevice ya existe. En Debian es normal, porque el paquete la crea al instalarse, y la configuración sigue sin problemas.
Lo que escribe en /etc/pve/corosync.conf es esto:
quorum { device { model: net net { algorithm: ffsplit host: 192.168.104.4 tls: on } votes: 1 } provider: corosync_votequorum}
ffsplit (fifty-fifty split) es el algoritmo para clústeres con número par de nodos: un voto extra que solo se da a una de las dos mitades. La conexión va cifrada con TLS y certificado de cliente, de modo que otro equipo de la red no puede hacerse pasar por un nodo.
Y así queda el estado, visto desde los nodos y desde el propio QDevice:
Las tres letras de la columna Qdevice son las que hay que mirar cuando algo falla: A/NA indica si el nodo habla con el QDevice, V/NV si recibe su voto y MW/NMW es una opción avanzada que se deja como está. A,V,NMW en ambos nodos es el estado correcto. En el QDevice, corosync-qnetd-tool -l muestra qué clústeres atiende, que pueden ser varios a la vez sin configuración adicional, y corosync-qnetd-tool -s resume clientes y clústeres conectados.
Un dato de seguridad que conviene tener presente: aunque vuelvas a cerrar el acceso por contraseña, la clave de root del nodo queda autorizada en el QDevice. Desde ese nodo, root puede entrar como root en el QDevice. Si el QDevice es compartido o está en otra red, limita esa clave a las IP de los nodos con from="..." en authorized_keys, o retírala cuando no la necesites. Para volver a configurar el QDevice tendrás que restaurarla.
Prueba 2: cortar un nodo con el QDevice
Repetimos el apagado brusco de pve2 midiendo el quórum de pve1 cada segundo:
No hubo ni una muestra sin quórum. pve1 y el QDevice suman dos votos de tres, y /etc/pve siguió siendo escribible. Con HA, este es el momento en que pve1 arrancaría las máquinas de pve2.
Recuerda lo que el QDevice no resuelve: el quórum no es capacidad. Si pve1 no tiene CPU y memoria libres para lo de pve2, el voto extra no arranca nada. Con dos nodos, cada uno debería poder con todo lo importante, o al menos tener decidido qué se arranca y qué no.
Prueba 3: el QDevice cae
Paramos corosync-qnetd con los dos nodos sanos. Veinte segundos después:
El clúster sigue con quórum, porque dos de tres basta, y nada se interrumpe. Es lo que dice la documentación: en clústeres pares, un QDevice caído te deja igual que si no lo tuvieras. Lo que se pierde es el margen. Con el QDevice todavía parado, cortamos pve2 y pve1 perdió el quórum en unos diez segundos, igual que en la prueba 1.
Así que el QDevice se monitoriza como cualquier otro servicio. Un QDevice caído no da síntomas hasta que falla también un nodo, y entonces ya es tarde. Basta con alertar si la columna deja de decir A,V o si el puerto 5403 no responde.
Prueba 4: la red se parte entre los dos nodos
Es el caso que de verdad justifica el QDevice. Bloqueamos con iptables todo el tráfico entre pve1 y pve2, pero dejamos que ambos llegaran al QDevice. Cada nodo ve que el otro ha desaparecido, y sin árbitro los dos tendrían la misma pretensión.
El QDevice resolvió el empate según su regla por defecto: el voto va a la partición con el ID de nodo más bajo. pve1 se quedó con el quórum y pve2, bloqueado. En la interfaz web de pve2 se veía lo contrario que en la de pve1: el otro nodo caído y el estado en rojo.
Dos consecuencias prácticas:
El nodo 1 gana los empates. Si uno de los dos servidores es más potente o tiene más servicios críticos, que sea el primero en crear el clúster. El criterio se puede cambiar con la opción tie_breaker de corosync-qdevice, reiniciando el servicio en todos los nodos.
Con HA, el nodo que pierde se reinicia solo. Es el comportamiento correcto: es preferible reiniciar pve2 a que pve1 y pve2 arranquen la misma máquina sobre el mismo almacenamiento.
Al quitar el bloqueo, pve2 volvió al clúster en menos de diez segundos y los dos nodos recuperaron A,V,NMW.
Lo que no hay que hacer: two_node: 1
En foros aparece a menudo otra salida: poner two_node: 1 en la sección quorum de corosync.conf. Es una opción real de Corosync que fija el quórum en uno. Según su manual, activa también wait_for_all, que obliga a que los dos nodos se hayan visto al menos una vez antes de dar quórum tras un arranque.
No la hemos probado en este laboratorio y no es lo que documenta Proxmox, que para dos nodos recomienda el QDevice. El motivo se ve en la prueba 4: ante una partición, el QDevice elige un ganador, mientras que con two_node cada nodo se apoya en su propio voto. Con un tercer equipo tan barato como un miniPC, no compensa el riesgo.
Retirar el QDevice o pasar a tres nodos
Si algún día añades un tercer servidor, primero hay que quitar el QDevice. Lo dice la documentación, y el código de pvecm se niega a configurarlo en clústeres impares salvo que se fuerce, en cuyo caso usa otro algoritmo (lms) que Proxmox desaconseja.
pvecm qdevice remove
En el laboratorio funcionó a la primera: borró el dispositivo de corosync.conf y los certificados de los nodos, y paró y deshabilitó corosync-qdevice en ambos. Encontramos dos detalles que no vienen en las guías:
Exige los dos nodos en línea, igual que la configuración. Si un nodo ha muerto del todo, primero hay que sacarlo del clúster.
La marca Qdevice no desaparece del estado hasta que se reinicia Corosync. pvecm status seguía mostrando NA,NV,NMW y «Qdevice (votes 0)», aunque los votos esperados ya eran dos. No tiene efecto, porque el dispositivo aporta cero votos, y desaparece con el siguiente reinicio planificado. No merece la pena forzarlo en producción con HA activa.
En el QDevice no se toca nada. La clave SSH sigue autorizada, y eso permitió volver a añadirlo después sin abrir la contraseña de root.
Lista de comprobación
Misma versión de Proxmox en los dos nodos, con nombre e IP fijos.
Red de Corosync en /etc/network/interfaces, y mejor con dos enlaces.
Clúster creado en el nodo que debe ganar los empates.
QDevice en una máquina que no comparta corriente, switch ni ubicación con los nodos.
corosync-qnetd en el QDevice y corosync-qdevice en los dos nodos.
Clave SSH del nodo copiada al QDevice antes de la configuración, sin abrir la contraseña de root.
pvecm status con 3 votos esperados, Quorate Qdevice y A,V,NMW en los dos nodos.
Alerta si el QDevice deja de votar.
Recursos suficientes en cada nodo para asumir lo importante del otro.
Prueba de fallo real, cortando la corriente, antes de confiar en el clúster.
Cómo lo hacemos en Cloud Privado
Cuando montamos clústeres de dos nodos, el tercer voto está en otra ubicación, en otra red eléctrica, y se monitoriza como el resto. Si estás valorando dos nodos con QDevice frente a tres nodos, o quieres que alguien rompa tu clúster antes de que lo haga la realidad, en Proxmox en cloud privado contamos cómo trabajamos.
Preguntas frecuentes
¿Puedo usar un clúster Proxmox de dos nodos sin QDevice?
Sí, funciona, pero cuando cae un nodo el otro pierde el quórum: no puedes cambiar la configuración y la alta disponibilidad no actúa. Las máquinas que ya estaban en marcha siguen funcionando. Para salir del paso existe pvecm expected 1, que debe usarse solo cuando estás seguro de que el otro nodo está apagado.
¿Qué necesita la máquina del QDevice?
Muy poco. En nuestra prueba, corosync-qnetd ocupaba unos 13 MB de memoria. Sirve un miniPC, una Raspberry Pi o una VM pequeña, siempre que esté fuera del clúster y que no falle a la vez que uno de los nodos. Necesita el puerto TCP 5403 accesible desde los nodos.
¿El QDevice tiene que estar en la misma red que los nodos?
No. A diferencia de Corosync, se comunica por TCP y no exige baja latencia, así que puede estar en otra sede o en otro centro de datos. Lo que sí necesita es conectividad estable con los dos nodos.
¿Qué pasa si se cae el QDevice?
Nada inmediato: el clúster sigue con quórum, con dos votos de tres. Pero pierdes el margen, y si después cae un nodo, el otro se queda sin quórum. Por eso hay que monitorizarlo.
¿Por qué falla pvecm qdevice setup con «Permission denied»?
Porque el comando entra como root por SSH en el QDevice y Debian no permite por defecto el acceso de root con contraseña. Lo más seguro es copiar antes la clave pública de root del nodo al authorized_keys del QDevice. La alternativa es abrir el acceso solo durante la configuración y cerrarlo después.
¿Un mismo QDevice puede servir a varios clústeres?
Sí. corosync-qnetd atiende a varios clústeres a la vez sin configuración adicional, y cada uno recibe su propio certificado al ejecutar pvecm qdevice setup. Ten en cuenta que, si ese equipo cae, todos esos clústeres pierden el margen a la vez.
¿Tengo que quitar el QDevice si añado un tercer nodo?
Sí, antes de añadirlo. Proxmox recomienda el QDevice para clústeres pares y lo desaconseja en impares. Con tres nodos el quórum ya aguanta la caída de uno.
Fuentes
Proxmox, Cluster Manager (pvecm), documentación 9.2.14 del 6 de noviembre de 2026: creación y unión de nodos, QDevice, banderas de estado, desempate y retirada. Y el Roadmap, que sigue en Proxmox VE 9.2 a 18 de noviembre.
Código de pvecm.pm en pve-cluster: ssh-copy-id con la clave del nodo, comprobación de nodos en línea, algoritmos ffsplit y lms, y limpieza al retirar el QDevice.
Pruebas propias del 18 de noviembre de 2026: dos nodos con Proxmox VE 9.2 arm64 (pve-manager 9.2.29, Corosync 3.2.0-pve1) y un QDevice con corosync-qnetd 3.0.3, en máquinas virtuales Debian 13.7. Sin máquinas virtuales dentro ni recursos de HA: lo que se cuenta sobre HA y el watchdog procede de la documentación.
¿Tienes un clúster de dos nodos y no sabes qué pasaría si mañana cae uno? En Cloud Privado lo revisamos contigo, lo dejamos con su tercer voto y lo probamos rompiéndolo, sobre Proxmox gestionado en centros de datos en España.
¿Proxmox en producción sin llevarlo tú?
Si prefieres no cargar con la operación, dinos qué tienes y qué te falta. Te contamos qué opciones hay para llevarlo gestionado.
¿Te ha resultado útil? Compártelo o resúmelo con IA