Un vistazo en 30 segundos
- El 21 de septiembre de 2007 Robert Griesemer, Rob Pike y Ken Thompson empezaron a dibujar Go en una pizarra de Google. La FAQ oficial lo cuenta sin adornos: nació de la frustración con los lenguajes que usaban.
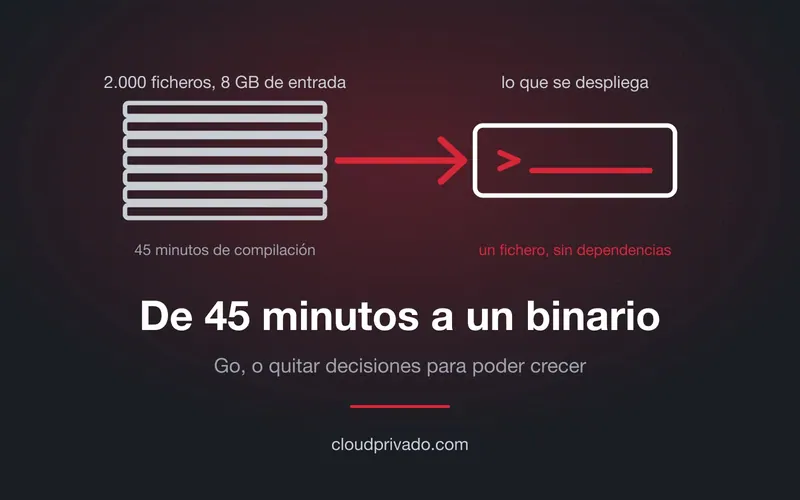
- El dato que explica la frustración: un binario de Google de 2007 tenía 2.000 ficheros fuente y 4,2 MB de código, pero al expandir los
#include llegaban más de 8 GB al compilador. Compilarlo eran 45 minutos con un sistema distribuido.
- La apuesta fue quitar, no añadir: pocas construcciones, un formateador oficial (
gofmt) que cierra el debate del estilo, y el objetivo declarado de compilar un ejecutable grande en segundos.
- Le costó caro en reputación. La ausencia de genéricos y una frase de Rob Pike sacada de contexto le colgaron la etiqueta de «lenguaje para programadores torpes».
- Los genéricos llegaron en Go 1.18, en marzo de 2022, y la historia sigue: Go 1.27, publicada el 19 de agosto de 2026, añade métodos genéricos.
- Para quien opera plataformas, lo relevante es otra cosa: el binario único. Docker, Kubernetes, Prometheus, Terraform, etcd, containerd, Grafana y buena parte de lo que instalas en tus nodos son un solo fichero sin dependencias.
- Y tiene una contrapartida que sí te toca: una CVE en una biblioteca de Go no se arregla con
apt upgrade. Hay que recompilar y redesplegar cada binario afectado.
Hay una escena que en 2007 se repetía en Mountain View: alguien lanzaba la compilación de un binario grande y se iba a por café. No un café rápido. Rob Pike lo contó años después en una charla que sigue siendo la mejor explicación de por qué existe Go: los tiempos de compilación, «incluso en clústeres de compilación grandes, se habían estirado a muchos minutos, y a veces horas».
El caso concreto que da es el que mejor se entiende. Un binario de Google de aquel año tenía unos 2.000 ficheros fuente que, concatenados, sumaban 4,2 MB. Después de expandir los #include, al compilador le llegaban más de 8 GB: dos mil bytes por cada byte de fuente C++ escrito por una persona. Aquel binario tardaba 45 minutos en construirse con el sistema distribuido de la casa, y 27 con una versión mejorada.
Eso no es un problema de lenguaje. Es un problema de escala, y por eso la historia de Go interesa mucho más allá de la guerra de siempre entre lenguajes.
El problema no era C++, era el tamaño de Google
La versión popular dice que Ken Thompson se hartó de C++ y se inventó algo mejor. La FAQ oficial de Go es bastante menos épica y bastante más útil:
Go nació de la frustración con los lenguajes y entornos existentes para el trabajo que hacíamos en Google. Programar se había vuelto demasiado difícil, y la elección de lenguajes tenía parte de culpa.
Lo que había detrás era una situación de la que casi ninguna empresa puede hablar: millones de líneas de software, miles de ingenieros trabajando sobre la cabeza de un único árbol de código que contiene todo, y un grafo de dependencias donde cada #include de más se paga multiplicado por dos mil. Google llegó a tocar su sistema de compilación en 2003 y con eso solo, sin cambiar código, los binarios típicos adelgazaron un 40%.
Thompson ya había pasado por algo parecido. Con Dennis Ritchie y el resto del grupo de Bell Labs había construido Unix, un sistema cuyo modelo acabó copiándose muchísimo más de lo que se copió su código. Conviene decirlo con precisión, porque circula mucha exageración: Linux no deriva del código fuente de Unix, reproduce su modelo; Android usa el kernel de Linux; macOS viene de otra rama, la de Darwin, con piezas de BSD, NeXT y Mach. Llamar a Thompson «el padre de todos los sistemas operativos modernos» queda bien en un titular, pero el árbol genealógico real es bastante más enredado.
Lo que sí es cierto es que treinta y tantos años después se encontró con la misma pregunta de ingeniería: cómo evitar que un sistema acumule tanta complejidad que la complejidad misma se convierta en el obstáculo.
En la pizarra de aquel 21 de septiembre había tres objetivos que, según la propia FAQ, ningún lenguaje mayoritario ofrecía a la vez: compilación eficiente, ejecución eficiente y facilidad para programar. Se podían elegir dos. La lista completa de lo que les molestaba incluye la complejidad excesiva para construir proyectos grandes con los sistemas de compilación asociados, y que los multiprocesadores ya eran universales mientras casi ningún lenguaje ayudaba a programarlos sin pegarse un tiro en el pie.
El cronograma de después es más lento de lo que la gente recuerda. Thompson empezó el compilador en enero de 2008, y aquella primera versión generaba C. En mayo pasó a ser un proyecto a tiempo completo, Ian Taylor arrancó por su cuenta un frontend de GCC para Go, y a finales de año se incorporó Russ Cox para llevarlo de prototipo a lenguaje de verdad. La publicación como software libre fue el 10 de noviembre de 2009.
Lo que Go quitó a propósito
La decisión de diseño que define Go no es ninguna de las que suelen citarse. Es esta: en vez de añadir mecanismos para acomodar cada estilo de programación posible, sus autores redujeron el número de decisiones que puede tomar quien escribe el código.
Para una persona sola eso puede resultar irritante. Para una organización con cientos de ingenieros tocando el mismo árbol tiene un efecto que se nota en el día a día: menos elecciones individuales producen más uniformidad en el conjunto, y leer el código de otro deja de ser una aventura.
El ejemplo más claro sigue siendo gofmt. En la mayoría de lenguajes, los equipos mantienen guías de estilo con reglas sobre indentación, espacios, saltos de línea y dónde va cada llave, además de las discusiones periódicas para revisarlas. Go trae una herramienta oficial que formatea el código de una única manera, y se acabó la conversación. La FAQ lo enmarca como parte de un objetivo mayor: que el lenguaje ayude «automatizando tareas mundanas como el formateo del código y quitando obstáculos para trabajar en bases de código grandes».
Lo mismo con las dependencias. Uno de los objetivos originales era que el código fuente contuviera información suficiente para construirse solo, sin un Makefile obligatorio ni un sistema de compilación externo por encima. Quien haya heredado un proyecto C++ con tres capas de generadores de build sabe exactamente cuánto vale eso.
Y el listón de velocidad estaba escrito: construir un ejecutable grande en un solo ordenador debía llevar, como mucho, unos pocos segundos.
De «lenguaje para programadores torpes» a lenguaje del cloud
La simplicidad se pagó. Las primeras versiones de Go no tenían genéricos, no adoptaron el modelo clásico de excepciones ni la herencia de clases de Java y C++, y eso levantó críticas desde el minuto uno.
A la mala fama contribuyó una frase concreta. En Lang.NEXT 2014, explicando para quién estaba pensado el lenguaje dentro de Google, Rob Pike dijo que sus programadores «no son investigadores», que suelen ser jóvenes recién salidos de la universidad, y que «no son capaces de entender un lenguaje brillante, pero queremos usarlos para construir buen software». De ahí a la etiqueta de «lenguaje para programadores tontos» hubo un paso, y el paso borró el argumento de Pike, que era otro: Google necesitaba software que equipos enormes pudieran entender y mantener durante años, no un lenguaje que luciera en un paper.
Unos años más tarde apareció el entorno que le venía como anillo al dedo. Los contenedores, los sistemas distribuidos y la infraestructura cloud crearon demanda de software que se compilara rápido, se distribuyera sin drama y se desplegara en máquinas que no son la del desarrollador.
Docker se escribió en Go. Kubernetes, publicado por Google en 2014, también. Detrás vinieron Prometheus, etcd, containerd, Terraform, Consul, Vault, Grafana, Traefik, Caddy, restic, rclone y una lista que no se acaba. Si administras plataformas, la mitad de lo que instalas esta semana será un binario de Go, lo sepas o no.
En este mismo blog se nota sin buscarlo. De las herramientas del entorno de Proxmox que hemos revisado en los últimos meses, están escritas en Go Pulse, ProxSave, VaultS3 y el orquestador de la edición Enterprise de ProxCenter. No es casualidad ni moda: es que el perfil de esas herramientas —un servicio pequeño que habla con una API, se instala en un nodo y no debe traerse medio sistema operativo detrás— es exactamente para lo que Go va bien.
Lo que Go cambia en tu operación
Aquí es donde la historia deja de ser una anécdota de 2007 y empieza a tocarte el día a día. Estas son las consecuencias reales de que tu infraestructura esté escrita en Go, incluidas las incómodas.
El binario único, que es casi todo el motivo
Go compila a código nativo y enlaza estáticamente por defecto. El resultado es un fichero que copias y ejecutas: sin intérprete, sin runtime que instalar, sin resolver un árbol de paquetes en la máquina de destino y sin la conversación de «en mi entorno funciona».
Para quien publica software eso significa poder entregar un ejecutable sin exigir que el administrador reproduzca el entorno de desarrollo. Para quien lo instala significa que actualizar es sustituir un fichero y reiniciar un servicio. En contenedores lleva a imágenes construidas desde cero, sin distribución base debajo, de unas pocas decenas de megas y con muy poco donde rebuscar si alguien entra.
La compilación cruzada va en el mismo saco. Cambiar GOOS y GOARCH produce el binario para otra plataforma desde tu portátil, sin cadena de herramientas cruzada ni máquina de la arquitectura de destino. Con Proxmox VE corriendo ya en ARM64, esa propiedad ha dejado de ser teórica: las herramientas en Go suelen traer build para arm64 desde el primer día, y las que no lo traen se compilan en un minuto.
La contrapartida: el parcheo cambia de sitio
Esta es la parte que casi nadie cuenta y la que más cara sale.
Cuando una vulnerabilidad aparece en una biblioteca compartida del sistema, la cadena de siempre funciona: llega el paquete, apt upgrade, reinicias los servicios que la tenían mapeada y listo. Con Go eso no aplica, porque la biblioteca no está en el sistema, está dentro de cada binario. Una CVE en una dependencia obliga a que el proyecto recompile y publique una versión nueva, y a que tú la despliegues. Si el proyecto está abandonado, no hay parche que valga.
Lo cual quiere decir que tu inventario de software deja de ser la lista de paquetes instalados. Es la lista de binarios, con su versión y sus dependencias internas. Para eso hay dos herramientas que merece la pena conocer y que casi nadie usa fuera del mundo del desarrollo:
go version -m /ruta/al/binario te imprime, de un ejecutable ya compilado, la versión de Go con la que se construyó y el módulo y la versión de cada dependencia que lleva dentro. Funciona sobre binarios que no has compilado tú.govulncheck -mode binary /ruta/al/binario compara ese contenido contra la base de datos oficial de vulnerabilidades de Go. Sobre el código fuente, la herramienta filtra por alcanzabilidad y solo reporta lo que tu código realmente llama, que es lo que la hace poco ruidosa; sobre un binario no puede reconstruir el grafo de llamadas completo, así que es más conservadora y puede darte falsos positivos.
Si gestionas una flota, esto encaja de forma natural con el trabajo de inventario y parcheo que ya haces sobre los paquetes del sistema. Solo que hay que hacerlo también con la carpeta de binarios sueltos que todo el mundo tiene en /usr/local/bin y de la que nadie lleva la cuenta.
Contenedores: el runtime aprendió a mirar los límites
Durante años, un servicio en Go dentro de un contenedor con límite de CPU se comportaba mal por una razón tonta: el runtime miraba las CPU lógicas de la máquina física para decidir su paralelismo, ignorando el límite del cgroup. Un nodo de 64 hilos con un contenedor limitado a dos CPUs acababa con un GOMAXPROCS de 64, muchísimo cambio de contexto y latencias raras. La solución habitual era una biblioteca de terceros o fijar la variable a mano.
Go 1.25 lo arregló de serie: en Linux el runtime tiene en cuenta el límite de ancho de banda de CPU del cgroup y, si es menor que el número de CPUs lógicas, ajusta GOMAXPROCS a ese límite. Además lo revisa periódicamente, porque los orquestadores cambian los límites en caliente. Ojo a un detalle que importa en Kubernetes: mira el limit, no el request. Y si fijas GOMAXPROCS por variable de entorno o desde el código, todo ese comportamiento se desactiva.
El equivalente en memoria es GOMEMLIMIT, disponible desde Go 1.19: un tope blando que le dice al recolector de basura cuánta memoria puede llegar a usar, para que se ponga a trabajar antes de que el cgroup mate el proceso por OOM. En un contenedor con límite de memoria, no ponerlo es pedir un OOMKilled a las tres de la mañana. Es de las cosas que conviene revisar cuando montas Kubernetes sobre tu propia infraestructura y ves reinicios que no cuadran con la carga.
Lo que Go no te va a dar
Por honestidad, la otra cara:
- Los binarios son grandes. Un servicio pequeño ronda los 10-20 MB, porque el runtime y todo lo que usa van dentro. Frente a un ejecutable de C enlazado dinámicamente es mucho, aunque en 2026 rara vez sea el problema.
- Hay recolector de basura, con lo que eso implica. Las pausas son muy pequeñas y llevan años bajando, pero para latencias de microsegundos duras o para software que debe funcionar sin sorpresas de memoria hay otras respuestas. Ahí es donde ha crecido Rust, y se nota en las herramientas nuevas del entorno de Proxmox, cada vez más escritas en ese lenguaje.
- El tópico del consumo no siempre se cumple en la dirección que se supone. VaultS3, que es Go, arranca con 17 MiB de RAM en reposo según su propio proyecto, por debajo de alternativas escritas en Rust. Las cifras dependen mucho más del diseño del programa que del lenguaje.
Los genéricos: que sea simple no significa que esté congelado
La otra parte de la historia es cómo Go ha gestionado su propia rigidez.
Durante más de una década la petición más repetida por la comunidad fue el soporte para programación genérica, y el equipo se negó hasta encontrar un diseño que encajara con el resto del lenguaje. Los genéricos llegaron por fin en Go 1.18, el 15 de marzo de 2022, mediante tipos parametrizados; el propio proyecto lo describió como el mayor cambio del lenguaje desde su publicación como software libre.
Lo interesante del episodio es el mensaje que manda: la simplicidad no era inmovilidad. Y viene acompañado de una recomendación que el equipo repite desde entonces, resumida por Ian Lance Taylor: escribe funciones normales y mete parámetros de tipo cuando su utilidad sea evidente, no diseñes el programa alrededor de abstracciones genéricas desde el principio.
La evolución continúa. Go 1.27 se publicó el 19 de agosto de 2026 y trae métodos genéricos: ahora se pueden poner parámetros de tipo en métodos concretos de un tipo, lo que permite encadenar llamadas de izquierda a derecha en vez de esparcir funciones sueltas por el paquete. Con dos límites que el propio anuncio explica bien: los métodos genéricos en interfaces siguen sin existir, porque el compilador tendría que instanciar el método con todos los tipos posibles, y un método genérico concreto no puede satisfacer una interfaz.
Casi veinte años de distancia dan perspectiva suficiente para decir lo obvio: Go no «humilló» a C++, ni a Java, ni a ningún otro. Todos siguen resolviendo problemas para los que Go no es la respuesta. Lo que sí demostró es algo que a los que administramos sistemas nos suena mucho: un lenguaje puede ganar terreno no por ofrecer más posibilidades, sino por reducir el número de decisiones necesarias para construir, leer, compilar y desplegar software.
Lo que nos llevamos
El problema que Thompson, Pike y Griesemer intentaban resolver en 2007 no era hacer el lenguaje más sofisticado del mundo. Era conseguir que grupos grandes de ingenieros construyeran sistemas grandes sin que el proceso de desarrollo se convirtiera en otro problema de ingeniería.
Que la respuesta acabara siendo el idioma de Docker, Kubernetes, Prometheus y buena parte del software con el que hoy se opera un centro de datos convirtió una decisión de diseño interna en algo bastante más gordo que una discusión de lenguajes.
Para nosotros, la lectura práctica es la de siempre: la comodidad de instalar un binario no exime de saber qué hay dentro. En las plataformas que gestionamos, el inventario incluye los binarios sueltos, no solo los paquetes de la distribución; los límites de CPU y memoria de los contenedores se fijan pensando en cómo se comporta el runtime que hay debajo; y una CVE en una biblioteca de Go se trata como lo que es, una recompilación pendiente en cada servicio afectado. Si estás montando una plataforma con Kubernetes, Prometheus y compañía sobre infraestructura propia y quieres que alguien se ocupe de esa parte, cuéntanos cómo lo tienes y lo miramos contigo.
Preguntas frecuentes
¿Por qué creó Google el lenguaje Go?
Por los tiempos de compilación y la dificultad de trabajar con bases de código enormes. Su FAQ oficial habla de la frustración con los lenguajes existentes y de la complejidad excesiva para construir proyectos grandes; Rob Pike puso el ejemplo de un binario de 2007 cuyos 4,2 MB de fuentes se convertían en más de 8 GB tras expandir los #include y que tardaba 45 minutos en compilarse.
¿Quién creó Go y cuándo?
Robert Griesemer, Rob Pike y Ken Thompson empezaron a definirlo en Google el 21 de septiembre de 2007. El compilador arrancó en enero de 2008 y el lenguaje se publicó como software libre el 10 de noviembre de 2009.
¿Por qué se usa tanto Go en infraestructura cloud?
Por la combinación de compilación nativa, concurrencia integrada, biblioteca estándar amplia y, sobre todo, un binario estático que se distribuye y se despliega sin preparar un entorno de ejecución en la máquina de destino. Docker, Kubernetes, Prometheus, etcd, containerd y Terraform son los ejemplos más visibles.
¿Cómo se parchea una vulnerabilidad en un binario de Go?
Recompilando y redesplegando. Las dependencias van enlazadas dentro del ejecutable, así que actualizar una biblioteca del sistema no arregla nada. Para saber qué llevas dentro, go version -m sobre el binario lista sus módulos y versiones, y govulncheck -mode binary los compara con la base de datos de vulnerabilidades de Go.
¿Tiene Go genéricos?
Sí. Llegaron en Go 1.18, en marzo de 2022, más de una década después de la publicación del lenguaje. En Go 1.27, del 19 de agosto de 2026, se ampliaron con métodos genéricos sobre tipos concretos, aunque siguen sin poder usarse en interfaces.
¿Hay que tocar algo en Go al desplegar en contenedores?
Desde Go 1.25 el runtime ajusta solo GOMAXPROCS al límite de CPU del cgroup en Linux, así que ese ajuste manual sobra si el binario está compilado con esa versión o posterior. Lo que sí conviene fijar es GOMEMLIMIT acorde al límite de memoria del contenedor, para que el recolector de basura actúe antes de que el kernel mate el proceso.
Fuentes
- Go, Frequently Asked Questions — origen del lenguaje, fechas, objetivos de diseño y la cita sobre la frustración con los lenguajes existentes.
- Rob Pike, Go at Google: Language Design in the Service of Software Engineering — los 45 minutos de compilación, los 8 GB tras expandir los
#include y la escala del árbol de código de Google.
- Go, About the Go command — el objetivo de que el código fuente baste para construirse sin sistema de compilación externo.
- Go 1.18 y la llegada de los genéricos — fecha y alcance del mayor cambio del lenguaje desde su publicación.
- Go, When To Use Generics — la recomendación de Ian Lance Taylor sobre cuándo usarlos.
- Go, Generic Methods in Go 1.27 — métodos genéricos, publicado el 26 de agosto de 2026, y sus limitaciones con interfaces.
- Go, historial de versiones — Go 1.27.0 publicada el 19 de agosto de 2026.
- Go, Container-aware GOMAXPROCS y notas de Go 1.25 — el ajuste automático al límite de CPU del cgroup.
- Go, Vulnerability Management y documentación de govulncheck — base de datos de vulnerabilidades, filtrado por alcanzabilidad y modo binario.
- Go Was Born Because Google Took Hours to Compile: Ken Thompson’s Bet on Simplicity — el artículo que originó este.