Las claves en 30 segundos
- Proxmox SDN genera configuración de Linux, pero no la secuestra. Las redes van a
/etc/network/interfaces.d/sdn y lo que se añada en /etc/frr/frr.conf.local se suma a la configuración de FRR que genera Proxmox. Se puede extender sin pelearse con la interfaz web.
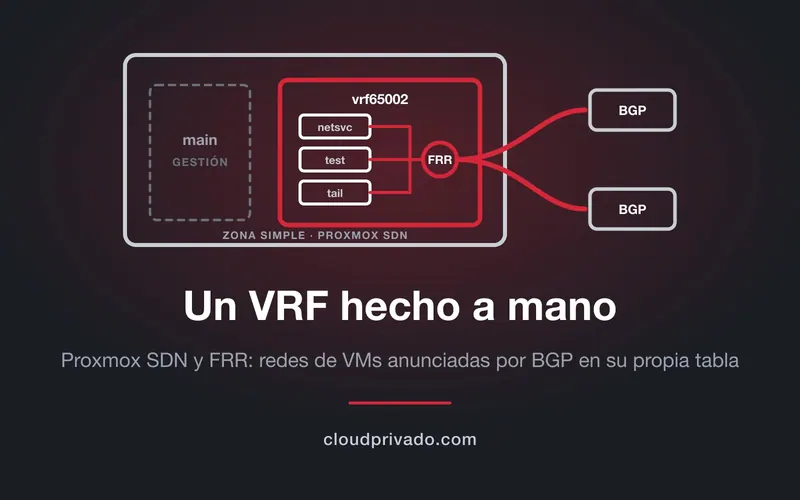
- El objetivo del montaje: que cada VNet nueva se enrute y se anuncie por BGP sola, pero en una tabla de rutas propia (un VRF), sin que un router externo pueda cambiar la ruta por defecto con la que se gestiona el hipervisor.
- EVPN ya da VRF, pero arrastra VXLAN y un plano de control pensado para varios nodos. Para un host y dos routers de toda la vida, una zona Simple + VRF de Linux + FRR es más directo.
- El punto débil: ifupdown2 no sabe que los puentes están en el VRF, así que cada SDN Apply los saca y los vuelve a meter, y las sesiones BGP de la interfaz física caen unos segundos.
- Proxmox lo está resolviendo: una serie de parches en revisión (RFC, 21 de octubre de 2026) añade VRF opcional a las zonas Simple. Hoy, en Proxmox VE 9.2, todavía no existe.
Hay una sensación que conoce cualquiera que llegue a Proxmox desde VMware y NSX: la red del hipervisor y la red del sistema operativo son mundos distintos, y mezclarlos es buscarse una tarde mala. En Proxmox esa frontera casi no existe, porque todo es Linux: puentes, VLAN, VXLAN y FRR. Eso, que al principio desconcierta, también permite hacer cosas que la interfaz no ofrece.
Kenyon Hensler lo cuenta con mucho humor en su blog, vskeeball.com, en un artículo del 1 de noviembre de 2026 cuyo título viene a decir «el VRF que, por lo visto, tuve que montar yo mismo». Partimos de su montaje, lo hemos contrastado con la documentación de Proxmox, FRR, el kernel de Linux y Tailscale, y hemos comprobado por nuestra cuenta un detalle de ifupdown2 que cambia cómo se puede hacer esto de forma declarativa.
Lo que Proxmox genera y lo que te deja añadir
La configuración de SDN vive en /etc/pve/sdn (zones.cfg, vnets.cfg, subnets.cfg), que es un sistema de ficheros replicado en todo el clúster. Al pulsar Apply, Proxmox la traduce a ficheros que entienden los servicios de Linux:
| Qué | Dónde lo escribe Proxmox | Dónde puedes añadir lo tuyo |
|---|
| Interfaces y puentes de las VNets | /etc/network/interfaces.d/sdn | Otros ficheros en /etc/network/interfaces.d/ |
| Enrutamiento (EVPN, BGP, fabrics) | /etc/frr/frr.conf | /etc/frr/frr.conf.local, que se añade encima |
La pieza que lo hace posible es una línea que la documentación de Proxmox exige al final de /etc/network/interfaces en todos los nodos:
source /etc/network/interfaces.d/*
Con ella, cualquier fichero de ese directorio entra en la red del host. Hensler lo aprovecha para declarar una interfaz enrutada en la VLAN 6 de un puente que ya es VLAN-aware, que es por donde hablará con sus routers:
auto vmbr0.6
iface vmbr0.6 inet static
    address 192.168.21.3/29
En su laboratorio, pfSense está en 192.168.21.1, un MikroTik en 192.168.21.2 y Proxmox en 192.168.21.3. El aviso razonable es el que él mismo hace: no conviene definir dos veces la misma interfaz en sitios distintos, porque Proxmox valida su parte y Linux no sabe de dónde viene cada línea.
Con FRR pasa igual. Lo que Proxmox genera para SDN acaba en /etc/frr/frr.conf de cada nodo, y lo que se escriba en frr.conf.local se añade. Para eso hacen falta los paquetes frr y frr-pythontools, y la red la gestiona ifupdown2, que viene por defecto desde Proxmox VE 7.0. En el repositorio de Proxmox VE 9, la versión de FRR disponible a 2 de noviembre de 2026 es la 10.6.1.
El problema: rutas aprendidas sí, pero no en la tabla del host
El objetivo era razonable: crear una red en Proxmox SDN, darle una puerta de enlace y que pfSense, el MikroTik y lo que haga falta la aprendan solos, sin rutas estáticas a mano en cada equipo. Con FRR es sencillo: si el host tiene una interfaz conectada a 192.168.22.0/24, redistribute connected la mete en BGP.
La pega está en dónde viven esas rutas. Linux tiene una tabla principal (main), la misma que usa el hipervisor para su IP de gestión y su puerta de enlace. Si BGP vuelca ahí lo que aprende, un router externo que anuncie una ruta por defecto puede cambiar por dónde sale el tráfico de gestión de Proxmox. Nadie quiere que una sesión BGP decida cómo se llega a la interfaz web del hipervisor.
La respuesta clásica de redes es un VRF (Virtual Routing and Forwarding): un contexto de enrutamiento separado dentro del mismo sistema. Hensler usó el VRF vrf65002, la tabla de Linux 65002 y el AS 65002 de BGP. Que coincidan no es obligatorio, solo práctico para leer la configuración.
Qué es un VRF en Linux (y la ruta que conviene ponerle siempre)
El kernel de Linux implementa los VRF como un dispositivo de red de tipo vrf asociado a una tabla de rutas. Es lo que se suele llamar VRF-lite: aislamiento de capa 3 dentro de una sola máquina, sin MPLS de por medio. Tres comportamientos de la documentación del kernel explican todo el montaje:
- Se mete una interfaz en el VRF con
ip link set dev X master VRF. Sus rutas conectadas y locales pasan solas a la tabla del VRF; otras rutas asociadas a esa interfaz se pierden y hay que volver a crearlas en la nueva tabla.
- Desde el kernel 4.8 basta una sola regla
l3mdev para todos los VRF, que el propio dispositivo instala al crearse el primero.
- Cada tabla de VRF debería llevar una ruta por defecto inalcanzable con métrica 4278198272.
Ese número no es arbitrario. FRR interpreta la métrica del kernel como distancia administrativa en el byte alto y prioridad en los tres bajos, así que 4278198272 equivale a [255/8192]: la peor distancia posible. Cualquier ruta por defecto que llegue por BGP la sustituye; si BGP la retira, el VRF responde «inalcanzable» en vez de colarse por la tabla del host. Es exactamente lo que hace el script de Hensler:
ip route add table 65002 unreachable default \
    metric 4278198272
¿Por qué no EVPN, si Proxmox ya crea VRF?
Es la pregunta obvia, y Hensler le dedica la parte más interesante del artículo (con alguna referencia a Bender de Futurama montando su propia SDN). Las zonas EVPN de Proxmox sí crean un VRF por zona y mantienen su enrutamiento aparte de la gestión. Pero resuelven un problema mucho mayor: extender redes entre varios nodos con VXLAN, puertas de enlace anycast distribuidas y anuncios MAC/IP por BGP EVPN, con nodos de salida (exit nodes) que anuncian la ruta por defecto hacia dentro del EVPN y conectan con la red física.
Él tenía un solo host, routers existentes y BGP IPv4 normal. Su comparación, resumida:
| Zona EVPN de Proxmox | Zona Simple + VRF a mano |
|---|
| Tabla de rutas separada | Nativa | VRF de Linux propio |
| VNets dentro del VRF | Nativo | Automatización propia |
| Puerta de enlace local para las VMs | Sí | Sí |
| Encapsulado VXLAN | Parte del diseño | Innecesario |
| Capa 2 extendida entre nodos | Sí | No |
| Plano de control | BGP EVPN | BGP IPv4 unicast |
| Salida a la red física | Modelo de exit nodes | VLAN enrutada dentro del VRF |
| Sesiones con pfSense y MikroTik | Integración adicional | Vecinos BGP directos en el VRF |
Y el matiz que más nos interesa: aun eligiendo EVPN, el diseño concreto que quería (su VLAN física dentro del mismo VRF, sus AS y políticas de siempre, una VM de Tailscale como vecino) habría requerido configuración a mano igualmente. Habría acabado retorciendo un diseño grande para que se comportara como uno pequeño.
Además, la decisión no cierra puertas. Proxmox admite varias zonas a la vez, así que una zona EVPN puede convivir con la Simple siempre que no choquen VRF, interfaces, VNI ni direccionamiento. Explicamos cuándo merece la pena EVPN, y cuándo no, en EVPN-VXLAN: cómo escalar la red del datacenter.
El montaje, pieza a pieza
La zona y las VNets son de lo más normal:
# /etc/pve/sdn/zones.cfg
simple: vrf65002
    nodes pve

# /etc/pve/sdn/vnets.cfg
vnet: netsvc
    zone vrf65002
vnet: test
    zone vrf65002
vnet: tail
    zone vrf65002
netsvc lleva las puertas de enlace de 192.168.11.0/24 y 192.168.12.0/24, test usa 192.168.22.0/24 y tail es un /30 (192.168.24.0/30) para la VM de Tailscale. Proxmox genera para cada VNet un puente de Linux corriente:
auto tail
iface tail inet static
    address 192.168.24.1/30
    bridge_ports none
    bridge_stp off
    bridge_fd 0
    ip-forward on
Lo que le falta es una línea: la que diría que el puente pertenece al VRF. Meterlo a mano es un comando (ip link set tail master vrf65002), pero solo sirve para los puentes que ya existen, y la gracia era no volver a entrar por SSH cada vez que se crea una red.
Un script que lee la configuración de Proxmox
Hensler escribió vrf65002-apply, que crea el VRF si no existe, mete la interfaz de BGP (vmbr0.6), añade la ruta inalcanzable y recorre las VNets de la zona leyendo /etc/pve/sdn/vnets.cfg. Ese detalle es el acierto del diseño: la fuente de verdad es la configuración de Proxmox, no una lista de puentes que alguien tenga que mantener. La función que engancha cada interfaz es idempotente:
attach() {
    local dev="$1"
    local current=""
    [ -e "/sys/class/net/$dev" ] || return 0
    if [ -L "/sys/class/net/$dev/master" ]; then
        current="$(basename "$(readlink \
            "/sys/class/net/$dev/master")")"
    fi
    [ "$current" = "$VRF" ] && return 0
    [ -z "$current" ] || \
        ip link set dev "$dev" nomaster || true
    ip link set dev "$dev" master "$VRF"
}
Lo difícil fue cuándo ejecutarlo. Proxmox crea y modifica puentes durante cada SDN Apply, no solo al arrancar. Acabó combinando servicios de systemd, una unidad path que vigila /etc/network/interfaces.d/sdn, hooks de red al levantar interfaces y una espera acotada para cubrir el hueco entre que Proxmox escribe el fichero y los puentes aparecen. Él mismo admite que es demasiada automatización para algo tan simple como enganchar puentes a un VRF.
FRR: una sola línea hace casi todo
Con los puentes dentro del VRF, la parte de FRR es corta. Una instancia BGP en el VRF, con pfSense (AS 65001), el MikroTik (AS 65000) y la VM de Tailscale (AS 65003) como vecinos:
router bgp 65002 vrf vrf65002
 bgp router-id 192.168.21.3
 no bgp default ipv4-unicast
 neighbor 192.168.21.1 remote-as 65001
 neighbor 192.168.21.2 remote-as 65000
 neighbor 192.168.24.2 remote-as 65003
 neighbor 192.168.24.2 ebgp-multihop 5
 !
 address-family ipv4 unicast
  redistribute connected route-map VRF65002-EXPORT
  neighbor 192.168.21.1 activate
  neighbor 192.168.21.1 route-map VRF65002-IMPORT in
  neighbor 192.168.21.1 route-map VRF65002-EXPORT out
  ! (igual para 192.168.21.2 y 192.168.24.2)
 exit-address-family
router bgp ... vrf NOMBRE asocia la instancia al VRF del kernel con ese nombre, y redistribute connected es la que evita escribir un network por cada subred: en cuanto un puente entra en la tabla 65002, su red se anuncia. La lista de exportación impide devolver a los routers la subred de enlace:
ip prefix-list VRF65002-EXPORT seq 5 deny 192.168.21.0/29
ip prefix-list VRF65002-EXPORT seq 100 permit 0.0.0.0/0 ge 1 le 32
Hensler avisa de que es una política deliberadamente amplia para un laboratorio, y la de importación también. En producción no la dejaríamos así: listas de prefijos explícitas por vecino, un tope de prefijos aceptados (maximum-prefix) y, si los vecinos lo admiten, BFD para detectar caídas en menos de un segundo. Es la misma lógica de mínimo privilegio que aplicamos a la microsegmentación con SDN y firewall en Proxmox.
La VM de Tailscale, o por qué no dejarlo en pfSense
Tailscale tiene paquete para pfSense, y Hensler lo usaba. Pero tenía fallos intermitentes (conectado a la VPN y sin llegar a recursos internos) y, sobre todo, un límite de plataforma que la documentación de Tailscale deja claro:
- En sistemas que no son Linux (FreeBSD, en el caso de pfSense, además de macOS y Windows), un subnet router solo puede funcionar en modo userspace («netstack»): termina y vuelve a originar los flujos TCP y UDP.
- Por defecto, un subnet router hace SNAT: los equipos internos ven como origen al router, no al dispositivo remoto.
- La opción para desactivarlo,
--snat-subnet-routes=false, solo funciona en Linux. La petición para exponerla en pfSense se cerró a la espera de que exista soporte en FreeBSD.
Él quería enrutamiento completo, con las direcciones de origen reales, para aplicar reglas de cortafuegos según quién conecta. Así que movió Tailscale a una VM Debian conectada a la VNet tail (192.168.24.2/30, puerta de enlace 192.168.24.1), con su propio FRR en el AS 65003 y una sesión eBGP multihop hacia el VRF de Proxmox.
Tailscale en Linux instala sus rutas en la tabla 52 mediante reglas de política, no en main, así que FRR no las ve. La solución está en FRR: redistribute table-direct importa a BGP las rutas de otra tabla del kernel sin copiarlas antes a la principal (a diferencia de redistribute table, que pasa por ip import-table):
router bgp 65003
 address-family ipv4 unicast
  redistribute table-direct 52 route-map TAILSCALE-TO-BGP
 exit-address-family
Durante las pruebas, Tailscale y BGP llegaron a anunciarse redes solapadas, FRR empezó a originar una ruta que ya aprendía de otro vecino y el tráfico se fue por donde no debía (la sesión SSH, como dice él, perdió interés en seguir la conversación). Además del filtro en el route-map, añadió una regla de política:
ip rule add pref 2500 lookup main suppress_prefixlength 0
Se lee así: consulta main antes que las reglas de Tailscale (que empiezan en la prioridad 5210), pero descarta cualquier resultado con prefijo de longitud 0 o menor, es decir, la ruta por defecto. Las rutas específicas de main, incluidas las aprendidas por BGP, ganan a la tabla 52; si main solo tiene la ruta por defecto, la búsqueda sigue y Tailscale puede responder. Es el mismo truco que usa wg-quick de WireGuard para no pisar la ruta por defecto del sistema; si te interesa esa otra vía, la contamos en tu propia VPN con WireGuard.
El resultado es una VM que funciona como un enlace enrutado más entre la tailnet y la red de casa. Más piezas que en pfSense, sí, pero con una ventaja que cualquiera que haya depurado una VPN a distancia aprecia: tocarla no pone en riesgo el cortafuegos del que depende todo lo demás.
Lo que todavía falla: ifupdown2 no ve el VRF
Este es el apartado que más valor tiene para quien quiera copiar el montaje. Al pulsar SDN Apply, Proxmox usa ifupdown2 para que la red en marcha coincida con la configuración generada. Y esa configuración no dice nada del VRF, porque la pertenencia la añade el script. Una simulación con ifreload -a -n -v (-n es «no actuar») enseña lo que ifupdown2 planea para el puente tail:
ip link set dev tail nomaster
ip link set dev tail down
ip link set dev tail up
Lo mismo con vmbr0.6 y el resto de puentes. Hensler capturó un Apply real con monitorización de netlink y los registros de FRR: las sesiones con pfSense y MikroTik cayeron por Interface down y se restablecieron poco después, mientras bgpd y zebra seguían en marcha. La sesión con Tailscale sobrevivió a una de las recargas. Los scripts reenganchan todo, pero hay unos segundos de corte en cada cambio de SDN.
El graceful restart de BGP no lo arregla, y conviene entender por qué: conserva rutas cuando se reinicia el plano de control, pero no mantiene el tráfico por una interfaz que Linux acaba de tumbar. La solución limpia es que ifupdown2 sepa desde el principio que esas interfaces están en el VRF. Proxmox VE 9.2 añadió una ayuda en ese sentido: se puede simular un cambio de SDN antes de aplicarlo, lo que al menos permite ver el corte venir.
La vía declarativa tiene una trampa con el número de tabla
ifupdown2 entiende VRF de forma nativa: un dispositivo con vrf-table y, en cada interfaz miembro, el atributo vrf. La tentación sería declararlo así en un fichero propio. Lo hemos comprobado en el paquete de Proxmox (ifupdown2 3.3.0-1+pmx12): el módulo vrf solo acepta tablas entre 1001 y 5000 y da error con cualquier otra («out of reserved range»), salvo que se cambie ese rango por política del módulo. La tabla 65002 de este montaje no pasaría, y vrf-table auto asigna una del mismo rango.
El problema de fondo sigue ahí aunque se elija bien el número: los puentes los define Proxmox en interfaces.d/sdn, y añadirles vrf desde otro fichero es justo la «definición competidora» que conviene evitar. Por eso tiene sentido lo que viene.
Lo que prepara Proxmox: VRF en las zonas Simple
Hensler encontró la serie de parches en la lista pve-devel, y la hemos seguido. Se titula «SDN VRF support», la firma Gabriel Goller (Proxmox) y la segunda versión se envió como RFC el 21 de octubre de 2026: 15 parches repartidos entre proxmox-ve-rs, proxmox-perl-rs, pve-network y pve-manager. Lo que propone:
- Los VRF no serán un objeto aparte en la interfaz. La primera versión los trataba así y se descartó porque, según la carta de presentación, son un detalle de implementación: las zonas ya son la pieza lógica de capa 3 y deben mapearse a VRF.
- Las zonas Simple tendrán VRF opcional. Una casilla, marcada por defecto, mantiene la zona en el VRF por defecto; al desmarcarla se crea uno dedicado llamado
vrf_ seguido del nombre de la zona.
- Las zonas EVPN generarán siempre su VRF, y las fabrics de BGP y OSPF podrán ejecutarse dentro del VRF de una zona.
- La fuga de rutas entre VRF (route leaking) queda para después, porque depende de un cambio en FRR (el PR 22426, «zebra-native VRF route import») que a 2 de noviembre sigue abierto.
El Roadmap oficial de Proxmox ya lista entre lo previsto «soporte explícito de VRF como primitiva de primera clase de SDN». Y encaja con lo que llegó en la 9.2: BGP y WireGuard como nuevos protocolos de fabric (las fabrics aparecieron en la 9.0 con OpenFabric y OSPF), y route maps y listas de prefijos en la propia configuración de SDN, que es parte de lo que hoy hay que escribir en frr.conf.local.
Para quien tenga un montaje como este hay dos detalles a vigilar cuando llegue. El VRF tendrá un nombre generado (una zona llamada vrf65002 daría vrf_vrf65002), así que habrá que retocar la instancia BGP. Y la carta no explica cómo se asignarán los números de tabla. Mientras sea un RFC, no es una función disponible: en Proxmox VE 9.2, que sigue siendo la versión vigente, una zona Simple no tiene VRF.
Nuestra lectura
El artículo de Hensler es un laboratorio doméstico contado con gracia, pero el patrón sirve en una empresa: separar el plano de gestión del hipervisor del enrutamiento de las cargas y dejar que las redes nuevas se anuncien solas a los routers existentes, sin desplegar una fabric EVPN cuando solo hay uno o dos nodos con salida a la misma red. Es habitual en un clúster pequeño en housing, en una sede remota o en un entorno de pruebas que tiene que hablar con el núcleo de red del cliente.
Si lo montáramos para producción hoy, cambiaríamos tres cosas:
- Políticas de importación y exportación cerradas, con prefijos explícitos y límite de rutas por vecino.
permit 0.0.0.0/0 ge 1 le 32 está bien para aprender, no para un entorno con terceros.
- Ventanas de mantenimiento para los cambios de SDN mientras el VRF lo gestione un script, usando la simulación de la 9.2 para saber qué interfaces se van a mover. Y documentado, porque el siguiente técnico no sabrá que existe
vrf65002-apply.
- Un plan de salida hacia la función nativa en cuanto se publique, para quitar el script, que es la pieza frágil.
Con más de un nodo, o si las VMs tienen que moverse entre hosts conservando la IP, la conversación cambia y EVPN sí compensa. Y en cualquier caso, el cortafuegos de Proxmox sigue siendo la otra mitad del diseño: lo repasamos en firewall, NAT y SDN en Proxmox.
Preguntas frecuentes
¿Proxmox VE 9.2 permite poner una zona Simple en un VRF desde la interfaz?
No. Solo las zonas EVPN crean un VRF. El soporte para zonas Simple está en una serie de parches en revisión (RFC del 21 de octubre de 2026) y aún no forma parte de ninguna versión publicada.
¿Puedo añadir configuración propia de FRR sin que Proxmox la borre?
Sí. Proxmox genera /etc/frr/frr.conf a partir de la configuración de SDN y añade encima lo que haya en /etc/frr/frr.conf.local de cada nodo. Lo que no conviene es redefinir en ese fichero instancias que ya genera Proxmox.
¿Por qué la ruta por defecto del VRF lleva la métrica 4278198272?
Porque FRR la interpreta como distancia administrativa 255, la peor posible. Así cualquier ruta por defecto aprendida por BGP la sustituye, y si desaparece el VRF devuelve «inalcanzable» en lugar de usar la tabla del host. Es la recomendación de la documentación del kernel de Linux.
¿Puedo declarar el VRF con ifupdown2 en lugar de un script?
El VRF en sí, sí, con vrf-table, pero ifupdown2 solo acepta por defecto tablas entre 1001 y 5000. El problema es que los puentes de las VNets los genera Proxmox, y añadirles el atributo vrf desde otro fichero crea definiciones duplicadas de la misma interfaz.
¿Por qué no usar Tailscale en pfSense como subnet router?
Porque en FreeBSD el subnet router funciona en modo userspace y no admite --snat-subnet-routes=false, que solo existe en Linux. Sin esa opción, los equipos internos ven como origen al router y no al dispositivo remoto.
Fuentes
- Kenyon Hensler, «Proxmox SDN, FRR, and the VRF I Apparently Had to Build Myself», en vskeeball.com (1 de noviembre de 2026): vskeeball.com/2026/11/01/proxmox-sdn-frr-and-the-vrf-i-apparently-had-to-build-myself.
- Proxmox VE, documentación de Software-Defined Network (versión 9.2.13): pve.proxmox.com/pve-docs/chapter-pvesdn.html.
- Proxmox VE, Roadmap y notas de la versión 9.2: pve.proxmox.com/wiki/Roadmap.
- Gabriel Goller, «SDN VRF support» (RFC, 21 de octubre de 2026), en la lista pve-devel: lore.proxmox.com/pve-devel/[email protected].
- FRRouting, PR 22426 «zebra-native VRF route import»: github.com/FRRouting/frr/pull/22426.
- FRRouting, documentación de BGP (
redistribute table-direct, BGP en VRF): docs.frrouting.org/en/latest/bgp.html.
- Kernel de Linux, Virtual Routing and Forwarding (VRF): docs.kernel.org/networking/vrf.html.
- Tailscale, subnet routers: tailscale.com/kb/1019/subnets.
- Tailscale, enrutamiento en kernel frente a userspace: tailscale.com/kb/1177/kernel-vs-userspace-routers.
- Comprobación propia del rango de tablas VRF en
ifupdown2 3.3.0-1+pmx12 (repositorio de Proxmox VE 9, módulo addons/vrf.py), 2 de noviembre de 2026.
¿Tienes un clúster Proxmox que tiene que hablar BGP con tu red sin que el enrutamiento de las VMs toque la gestión de los hosts? En Cloud Privado diseñamos y operamos Proxmox VE en centros de datos en España, con la red planificada desde el principio, y lo conectamos con tus sedes y con las nubes que ya uses. Si quieres revisarlo, hablemos.