Usamos cookies técnicas y, si lo aceptas, de analítica (Google Analytics 4) para
mejorar el sitio. Hasta entonces no se instalan cookies de analítica.
Más información en la política de cookies.
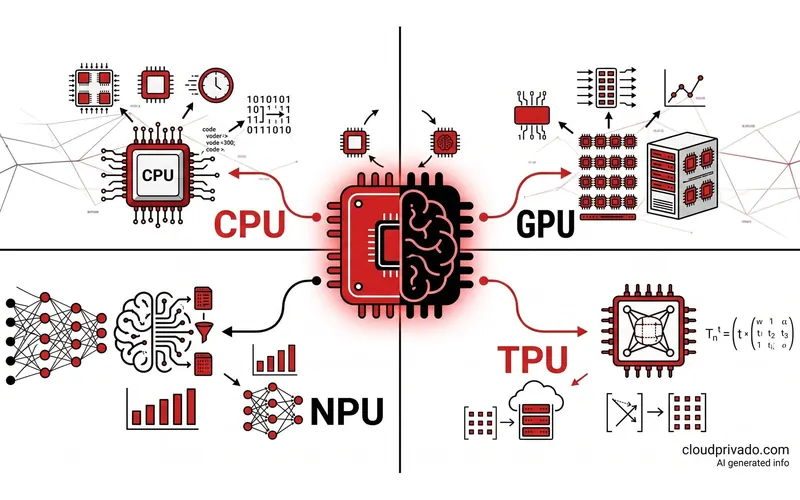
No hay un procesador mejor para IA. Hay cuatro papeles distintos: la CPU coordina y ejecuta cualquier cosa, la GPU hace muchísimas operaciones en paralelo, la NPU busca eficiencia por vatio en un equipo pequeño y la TPU es un ASIC de Google para aprendizaje automático.
TPU y ASIC no son categorías paralelas. Google define sus TPU literalmente como ASIC de desarrollo propio: la TPU es un caso concreto de la familia, no otra rama.
Y hay una consecuencia práctica que casi ninguna comparativa dice: la TPU no se puede comprar. Solo se usa desde Google Cloud, con Compute Engine, GKE o Vertex AI. Si montas infraestructura propia, no está en tu lista.
En inferencia, lo que manda casi siempre es la memoria, no los FLOPs. Generar un token obliga a leer los pesos del modelo enteros: con un modelo de 70.000 millones de parámetros en 8 bits —unos 70 GB— y una GPU de 3,35 TB/s, el techo aritmético ronda los 48 tokens por segundo por secuencia. Ese cálculo, y no el de operaciones pico, es el que predice lo que vas a ver.
Por eso la primera pregunta al dimensionar es cuánta VRAM y a qué velocidad, no cuántos teraflops. Un B200 lleva 192 GB de HBM3e a unos 8 TB/s; un H100, 80 GB.
Las NPU viven en portátiles y móviles: el listón de un Copilot+ PC son más de 40 TOPS. En un servidor casi no pintan nada, y aun en el portátil, si el modelo no está cuantizado y el runtime no las soporta, el trabajo se cae a la GPU o a la CPU sin que nadie te avise.
XPU no es una categoría, es un paraguas. DPU e IPU sí son reales, pero no calculan el modelo: mueven red, almacenamiento y seguridad para que la GPU no espere.
Y el error más caro no es elegir mal el acelerador: es comprar cómputo que luego no puedes alimentar —ni de datos, ni de electricidad, ni de refrigeración—.
Hace unos años, elegir procesador era elegir entre dos letras. Hoy una ficha técnica puede traer CPU, GPU, NPU, TPU, DPU, IPU, FPGA, ASIC y algún XPU suelto, y la mitad de esos nombres se usan con más entusiasmo que precisión.
La parte buena es que debajo del ruido hay un criterio bastante simple: cada uno de esos chips renuncia a algo para hacer mejor otra cosa. Y una vez sabes a qué renuncia cada cual, la pregunta deja de ser cuál es mejor y pasa a ser cuál encaja con lo que vas a ejecutar y con lo que puedes alimentar.
Qué hace cada uno, en una frase
La CPU es el procesador general. Pocos núcleos, pero cada uno preparado para ejecutar cualquier instrucción, saltar, decidir y coordinar. Ejecuta el sistema operativo, prepara los datos, orquesta procesos y, cuando el modelo es pequeño, también lo ejecuta sin drama.
La GPU nació para pintar píxeles, que es hacer la misma operación sobre millones de datos a la vez. Esa forma de trabajar resultó ser exactamente lo que necesitan las multiplicaciones de matrices de una red neuronal, y por eso la tarjeta gráfica acabó siendo el acelerador por defecto del aprendizaje profundo.
La NPU es un acelerador de redes neuronales pensado para que un portátil o un móvil ejecute modelos sin fundir la batería. Menos flexible que una GPU y con un objetivo distinto: rendimiento por vatio.
La TPU es el ASIC de Google para aprendizaje automático. Su documentación lo dice sin rodeos: circuitos integrados de aplicación específica desarrollados por la casa, construidos alrededor de un array sistólico de 128×128 y con memoria HBM en el propio chip.
Qué es
Fuerte en
En IA se usa para
Dónde vive
CPU
Procesador general
Flexibilidad, latencia baja, control
Preparar datos, orquestar, inferencia ligera
Todas partes
GPU
Acelerador paralelo
Matrices, ancho de banda de memoria
Entrenamiento e inferencia
Estación de trabajo, servidor, nube
NPU
Acelerador de redes neuronales
Eficiencia por vatio
Inferencia local y continua
Portátil, móvil, edge
TPU
ASIC de Google
Operaciones matriciales a escala
Entrenamiento e inferencia grandes
Solo Google Cloud
FPGA
Lógica reprogramable
Rutas de datos a medida
Inferencia específica, señal, vídeo
Edge, telecomunicaciones, industria
ASIC de IA
Circuito de función fija
Rendimiento y consumo
Lo que se diseñó, y nada más
Centros de datos y dispositivos
DPU / IPU
Procesador de infraestructura
Red, almacenamiento, cifrado
No calcula el modelo
Clústeres grandes
Aquí ya hay un malentendido resuelto: la TPU es un ASIC, así que no tiene sentido ponerlas en columnas separadas como si compitieran. Lo que sí compiten son los productos concretos.
La pregunta que cambia la conversación: ¿qué se te queda corto primero?
Casi todas las comparativas terminan enfrentando cifras de operaciones por segundo. Es la parte menos útil, porque en la inmensa mayoría de despliegues el acelerador no se queda sin cálculo: se queda sin datos.
La aritmética es sencilla y conviene tenerla en la cabeza. Para generar cada token, un modelo de lenguaje tiene que leer todos sus pesos desde la memoria del acelerador. Si el modelo tiene 70.000 millones de parámetros y lo sirves cuantizado a 8 bits, eso son unos 70 GB que hay que recorrer entero por cada token generado.
Divide el ancho de banda de la memoria entre ese tamaño y tienes el techo teórico:
Con una GPU de 3,35 TB/s (el orden de un H100 con 80 GB de HBM3), salen unos 48 tokens por segundo por secuencia.
Con una de 8 TB/s (el orden de un B200 con 192 GB de HBM3e), unos 114.
Ninguna de esas dos cifras depende de los teraflops. Dependen de la memoria. Por eso una GPU con el doble de potencia de cálculo y el mismo ancho de banda no te da el doble de tokens, y por eso el salto de generación que de verdad se nota en inferencia es el de la memoria.
Y hay un segundo escalón antes de llegar ahí, que es donde se pierden muchos despliegues:
Cargar 70 GB de pesos son unos 10 segundos desde disco y algo más de uno por PCIe: se paga una vez, siempre que el modelo quepa.
La lectura del diagrama es la que gobierna el dimensionado real: entre el almacenamiento y la memoria del acelerador hay tres órdenes de magnitud. Una GPU de 40.000 euros alimentada por un pipeline de datos lento rinde como una de 10.000, y en el monitor lo verás como uso de GPU al 30 % sin saber por qué. Antes de comprar más cómputo, mide si el que tienes está esperando.
TPU: potentísima, y probablemente no es para ti
La TPU es un buen ejemplo de hasta dónde llega la especialización cuando alguien controla el chip y el software a la vez.
La generación actual, TPU7x (Ironwood), lleva 192 GB de HBM3e por chip con unos 7,4 TB/s de ancho de banda, se agrupa en slices que van desde 256 chips hasta superpods de 9.216, y en esa configuración máxima acumula del orden de 1,77 PB de memoria directamente accesible. Son números de otra liga.
El software es la otra mitad de la historia. El código pasa por XLA, que compila las operaciones para el hardware, y desde el 7 de abril de 2026 Google trabaja en TorchTPU para ejecutar PyTorch de forma nativa: su propio anuncio explica que resuelve una limitación real de PyTorch/XLA, que solo admitía código puramente SPMD, y avisa de algo muy sano: la portabilidad no borra el hardware, y una arquitectura pensada para dimensiones de atención de 64 no aprovechará una TPU que rinde mejor con 128 o 256.
Ahora la parte que casi nunca aparece en las comparativas: la TPU no se compra. Se usa desde Google Cloud —Compute Engine, GKE o Vertex AI— y punto. No hay TPU en una tienda ni en el rack de nadie más.
Eso convierte la elección en algo más que técnico. Si tu proyecto tiene requisitos de soberanía del dato o de jurisdicción, o si simplemente no quieres que tu plataforma dependa de un único proveedor con su propio compilador, la TPU deja de ser una opción por razones que no tienen nada que ver con su rendimiento. Y si comparas costes, recuerda que ahí no compras un chip: alquilas capacidad, con todo lo que eso implica cuando la carga es continua, que es justo el cálculo que hicimos entre bare metal con GPU y el hiperescalar.
NPU: muy útil en tu portátil, casi irrelevante en tu rack
Las NPU se han hecho famosas con los llamados AI PC, y la promesa tiene sentido: mantener modelos pequeños funcionando de forma continua —subtítulos, efectos de vídeo, transcripción, búsqueda local— sin encender una GPU de 200 vatios ni mandar nada a un servidor.
El listón lo puso Microsoft: un Copilot+ PC necesita una NPU capaz de más de 40 billones de operaciones por segundo (TOPS). Y ahí es donde conviene desconfiar de la cifra grande de la caja, por dos motivos que están en la propia documentación de Windows.
El primero es el formato. Muchas NPU solo trabajan con enteros de baja precisión, así que un modelo entrenado en FP32 hay que convertirlo —cuantizarlo, típicamente a INT8— para que pueda ejecutarse ahí. Un modelo sin cuantizar no usa la NPU, por muchos TOPS que anuncie el fabricante.
El segundo es el respaldo silencioso. Windows ML consulta qué aceleradores hay, elige el proveedor de ejecución más adecuado y, si el preferido falla o no está disponible, cae a la GPU o a la CPU. La aplicación sigue funcionando, tú no te enteras, y la eficiencia que habías comprado se queda sin usar. Si te importa, hay que medirlo: el propio administrador de tareas ya muestra el uso de NPU.
En un servidor, en cambio, la NPU es casi anecdótica. Los aceleradores de centro de datos son GPU y ASIC; el trabajo que hace una NPU en un portátil, en el rack lo hace directamente la GPU. Así que si estás dimensionando infraestructura, esta categoría se puede pasar rápido.
FPGA, ASIC, DPU, LPU, XPU: qué es real y qué es un folleto
Los FPGA son circuitos cuya lógica se reconfigura después de fabricarse. Sirven para construir rutas de datos muy específicas y encajan bien en procesamiento de señal, vídeo, telecomunicaciones e inferencia con requisitos de latencia muy estrictos. Su pega es el esfuerzo: programarlos no se parece a escribir código.
Los ASIC van al extremo contrario: el circuito se diseña para una función y ahí se queda. A cambio dan la mejor relación de rendimiento y consumo cuando el volumen justifica el desarrollo. Las TPU son el ejemplo más visible, pero hay muchos más, dentro y fuera de los grandes proveedores.
Las DPU e IPU son reales y están en clústeres serios, pero conviene entender su papel: no ejecutan el modelo. Descargan de la CPU la red, el almacenamiento, el cifrado y el movimiento de datos, que en un clúster de entrenamiento es exactamente lo que impide que los aceleradores se queden parados. Son infraestructura, no cómputo de IA.
LPU es un nombre comercial de una arquitectura concreta orientada a modelos de lenguaje. Existe el producto; no existe la categoría. Y XPU directamente no describe ninguna arquitectura: es un paraguas para hablar de computación heterogénea. Si una oferta te promete una XPU, la pregunta correcta es qué chip lleva dentro y qué software sabe usarlo.
Qué significa todo esto si el hardware es tuyo
Aquí es donde la comparativa deja de ser divulgación y empieza a tener factura. Estas son las decisiones que nos encontramos en los proyectos, en el orden en que importan.
1. Tu abanico real es más corto de lo que parece
Si montas infraestructura dedicada, las TPU quedan fuera por definición y las NPU no aplican. Lo que hay son GPU de centro de datos, con su ecosistema de software, y algún ASIC concreto si tienes volumen y un socio dispuesto. Media comparativa de internet, por tanto, no describe tu decisión: describe la de alguien que va a alquilar en la nube de Google.
2. Dimensiona por memoria, y luego por lo demás
El modelo tiene que caber. Si no cabe en una GPU, hay que repartirlo entre varias, y entonces la interconexión entre ellas pasa a ser parte del problema. La secuencia sensata es: cuánta memoria necesita el modelo con la precisión que vas a usar, cuánto ancho de banda hace falta para el rendimiento objetivo, y solo después cuánto cálculo. Añade margen: lo que ha hecho la IA con el precio de la RAM también se aplica a comprar tarde.
3. Decide desde el principio cómo vas a repartir la GPU
Una tarjeta por máquina virtual con passthrough por VFIO e IOMMU es lo más simple y lo más aislado. Si necesitas que varias cargas convivan en la misma tarjeta, MIG parte una GPU de centro de datos en hasta siete instancias con memoria y cómputo separados —un B200 lo admite—, y vGPU es la alternativa por licencia. Compartir sin partir, entregando la tarjeta entera a quien pasa por ahí, es cómodo y tiene los riesgos que ya comentamos con RunSnack: la memoria de la GPU no se limpia sola entre usuarios.
4. La CPU no ha desaparecido, y suele ser el cuello de botella
Cargar, descomprimir, decodificar, tokenizar y mover datos sigue siendo trabajo de CPU y de almacenamiento. En más de una instalación con GPU infrautilizada, el culpable era un pipeline de datos mal dimensionado o un disco compartido con otras cosas. Es la comprobación más barata que existe y casi nadie la hace antes de pedir presupuesto de otra tarjeta.
5. La factura eléctrica y térmica llega antes que la de cómputo
Un rack estándar de 4-5 kW no admite un nodo de GPU moderno. Esto ya no es un detalle de ingeniería: es la restricción que define hoy el mercado, y por eso en plazas como Ámsterdam el cuello de botella es la potencia disponible y no la conectividad. Antes de elegir acelerador conviene saber cuántos kilovatios por rack te garantiza tu proveedor y con qué refrigeración, porque esa cifra decide qué hardware puedes poner de verdad.
Lo que nos llevamos
La sopa de siglas se ordena sola en cuanto se acepta que no compiten entre sí: la CPU coordina, la GPU calcula en paralelo, la NPU ahorra vatios en un equipo pequeño, la TPU es el ASIC de una casa concreta y las DPU mueven datos para que nadie espere. La discusión útil no es cuál gana, es qué combinación necesita tu carga.
Y en esa conversación, la cifra grande del folleto —teraflops, TOPS— es casi siempre la menos informativa. Lo que decide si un despliegue va bien es cuánta memoria tiene el acelerador, a qué velocidad la lee, si tu software sabe usarlo y si el resto del sistema es capaz de mantenerlo alimentado de datos y de electricidad.
Si estás valorando hardware para una carga de IA concreta —entrenamiento, inferencia en producción o un entorno de pruebas que no se quede corto en seis meses—, cuéntanos qué modelo vas a ejecutar y lo dimensionamos contigo. Nuestras plataformas con GPU dedicada se diseñan por ahí: por lo que tiene que caber en memoria y por lo que hay que alimentar, no por la cifra de la portada.
Preguntas frecuentes
¿Qué es mejor para inteligencia artificial, CPU o GPU?
Para entrenamiento y para inferencia de modelos grandes, la GPU, por su paralelismo y su ancho de banda de memoria. La CPU sigue siendo imprescindible para ejecutar el sistema, preparar los datos y coordinar el trabajo, y basta por sí sola con modelos pequeños o cargas donde el acelerador no compensa.
¿Una TPU es más rápida que una GPU?
Depende de qué TPU, qué GPU, qué modelo, qué precisión y qué software. La diferencia práctica más importante no es de velocidad: la TPU solo se usa desde Google Cloud, mientras que las GPU se pueden comprar e instalar en infraestructura propia.
¿Una TPU es lo mismo que un ASIC?
Una TPU es un ASIC. Google define sus Tensor Processing Units como circuitos integrados de aplicación específica desarrollados por la propia compañía para acelerar aprendizaje automático. ASIC es la familia; TPU, un miembro concreto.
¿Puede una NPU sustituir a una GPU?
No en general. La NPU está pensada para ejecutar redes neuronales con muy poco consumo, normalmente con modelos cuantizados a enteros, y no es el objetivo del entrenamiento ni de los modelos generativos exigentes. En un portátil convive con la CPU y la GPU; en un servidor, el trabajo lo hace la GPU.
¿Qué significa que un portátil tenga 40 TOPS?
Es el listón que Microsoft fija para un Copilot+ PC: una NPU capaz de más de 40 billones de operaciones por segundo. Ojo, porque esa cifra no garantiza nada por sí sola: si el modelo no está cuantizado al formato que admite la NPU o el runtime no la soporta, el trabajo acaba ejecutándose en la GPU o en la CPU.
¿Qué es una XPU?
Un término paraguas para hablar de arquitecturas con varios tipos de procesador, no una categoría de hardware como CPU o GPU. Ante una oferta que hable de XPU, lo útil es preguntar qué acelerador concreto lleva y qué software puede aprovecharlo.
¿Para qué sirven las DPU y las IPU en un clúster de IA?
Para descargar de la CPU el tráfico de red, el almacenamiento, el cifrado y el movimiento de datos. No calculan el modelo, pero en un clúster grande son lo que evita que los aceleradores pasen el tiempo esperando datos.
Fuentes
Google Cloud, Introduction to Cloud TPU — definición de las TPU como ASIC propios, array sistólico de 128×128, memoria HBM y acceso exclusivo mediante Compute Engine, GKE y Vertex AI.
Microsoft Learn, Copilot+ PCs developer guide — el requisito de más de 40 TOPS, la necesidad de cuantizar los modelos y el respaldo automático a GPU o CPU cuando el proveedor de ejecución no está disponible.
Especificaciones públicas de NVIDIA para H100, H200 y B200 (capacidad y ancho de banda de HBM, particionado MIG) — usadas aquí como órdenes de magnitud, no como comparativa de producto.
¿Te ha resultado útil? Compártelo o resúmelo con IA