Usamos cookies técnicas y, si lo aceptas, de analítica (Google Analytics 4) para
mejorar el sitio. Hasta entonces no se instalan cookies de analítica.
Más información en la política de cookies.
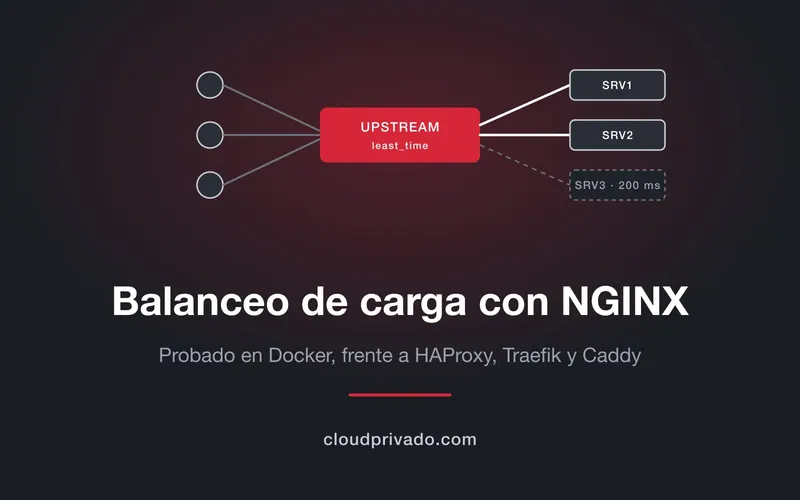
Con un servidor lento en el grupo, el método importa mucho. En nuestra prueba, el round-robin dejó la p95 en 203 ms; least_conn bajó el tiempo total de 8,3 a 3,3 segundos, y least_time bajó además la p95 a 26 ms.
Varias funciones que las guías dan como de pago ya son libres.sticky (afinidad por cookie) es de código abierto desde NGINX 1.29.6, least_time desde 1.31.0, y el keepalive con los backends va activado por defecto desde 1.29.7.
Pero depende de la versión que tengas. Debian 13 trae NGINX 1.26, que no tiene nada de eso. La rama estable 1.30 tiene sticky y el keepalive, pero no least_time.
Por defecto, NGINX entrega al cliente el 503 de un backend roto. En la prueba, una de cada tres peticiones falló hasta que añadimos http_503 a proxy_next_upstream.
Lo que sigue siendo de pago son los health checks activos. HAProxy, Traefik y Caddy los traen gratis, y con HAProxy el servidor quedó fuera de la rotación en unos dos segundos.
Quisimos ir un paso más allá y medirlo. Montamos un laboratorio en Docker, pusimos un servidor lento entre los rápidos, tiramos servidores de varias formas y repetimos lo mismo con tres alternativas de código abierto. Y al cruzar las guías con el registro de cambios de NGINX salió algo importante: buena parte de lo que se sigue contando sobre NGINX libre frente a NGINX Plus ha cambiado este año.
Cómo hemos hecho las pruebas
Todo corre en Docker 29.9 sobre un Mac con Apple Silicon, en una red interna de contenedores:
Tres servidores de aplicación (srv1, srv2 y srv3) con un pequeño servidor HTTP en Python 3.13 que responde con su nombre en una cabecera X-Backend, cuenta conexiones TCP y versión de HTTP, y puede simular lentitud o devolver 503 a voluntad.
El balanceador: NGINX 1.31.8 (la rama principal, del 21 de octubre), 1.30.6 (la estable) y 1.26 (la que instala Debian 13), con imágenes oficiales.
Un cliente en otro contenedor que lanza N peticiones con C conexiones a la vez y anota qué servidor respondió, el código y la latencia.
Las alternativas: HAProxy 3.4.7, Traefik 3.7.19 y Caddy 2.11.9, también con imágenes oficiales y la misma red.
Para comparar métodos, srv1 y srv2 tardan 20 ms en responder y srv3 tarda 200 ms. Es el caso que más se ve en producción: una máquina más vieja, una VM en un nodo cargado o un servidor que está haciendo una copia de seguridad.
Las cifras absolutas no valen fuera de este laboratorio. Lo que sí vale es la comparación entre métodos y productos, porque todos pasan por exactamente la misma prueba.
La base: un bloque upstream
NGINX balancea con un bloque upstream y un proxy_pass que apunta a él:
upstream app { zone app 64k; server 10.0.0.11:8080; server 10.0.0.12:8080; server 10.0.0.13:8080;}server { listen 80; location / { proxy_pass http://app; proxy_set_header Host $host; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header X-Forwarded-Proto $scheme; }}
Sin indicar método, NGINX usa round-robin. Con 300 peticiones seguidas, cada servidor recibió exactamente 100, en orden srv1 srv2 srv3 srv1 srv2 srv3….
La línea zone merece explicación, porque la guía de elhacker la sitúa en NGINX Plus o en módulos de terceros. zone es de código abierto desde la versión 1.9.0 y hace que el estado del grupo (conexiones activas, servidores caídos, límites) se comparta entre todos los procesos worker. Sin ella, cada worker lleva sus propias cuentas. Más abajo se ve lo que eso supone con max_conns.
Pesos: el reparto no es en bloque
Con weight=3 en srv1 y los otros dos a 1, de 500 peticiones srv1 recibió 300 y los otros 100 cada uno, como dice la documentación. Lo interesante es el orden:
No manda tres seguidas a srv1 y luego una a cada uno: las intercala. Es el round-robin ponderado «suave» que describe la guía de elhacker (con current_weight y effective_weight), y en la práctica significa que el servidor con más peso no recibe ráfagas.
Qué método elegir: la prueba con un servidor lento
Lanzamos 3.000 peticiones con 30 clientes a la vez contra el mismo grupo, cambiando solo el método:
Captura propia del laboratorio. El servidor srv3 responde en 200 ms y los otros dos en 20 ms. La última orden muestra que la rama estable de NGINX todavía no reconoce least_time.
Método
Peticiones a srv3 (lento)
p50
p95
Tiempo total
Round-robin (por defecto)
1.000
22 ms
203 ms
8,3 s
random
959
24 ms
204 ms
8,2 s
least_conn
160
22 ms
201 ms
3,3 s
random two least_conn
196
23 ms
202 ms
3,7 s
least_time header
38
22 ms
26 ms
2,5 s
least_time last_byte inflight
38
22 ms
26 ms
2,5 s
Lo que se lee aquí:
Round-robin y random no se enteran de que un servidor va lento. Le mandan un tercio del tráfico y uno de cada tres usuarios espera diez veces más.
least_conn sí reacciona, porque el servidor lento acumula conexiones abiertas y deja de recibir nuevas. El rendimiento total se multiplica por 2,5. Pero la p95 casi no baja: con 160 peticiones de 3.000 en el lento, algo más del 5 % sigue tardando 200 ms.
least_time mide el tiempo de respuesta y le manda al lento solo lo imprescindible para seguir midiéndolo. Es el único método que mejoró la p95.
random two least_conn (el «poder de dos opciones») queda cerca de least_conn. Su ventaja no se ve con tres servidores; tiene sentido con grupos grandes o cuando hay varios balanceadores que no comparten estado.
El matiz importante:least_time solo existe en NGINX 1.31.0 o posterior, la rama principal. La guía de elhacker lo da como exclusivo de NGINX Plus, y eso era cierto hasta mayo. Hoy la documentación del módulo upstream lo dice claramente: «Prior to version 1.31.0, this directive was available only as part of our commercial subscription». En 1.30.6 y en 1.26, nginx -t lo rechaza como directiva desconocida.
Otra cosa que conviene saber: least_time premia al servidor que responde antes, y un servidor que devuelve errores muy rápido también responde antes. Si una aplicación rota contesta 500 en un milisegundo, puede acabar recibiendo más tráfico. Por eso conviene combinarlo con las reglas de fallo que vemos más abajo.
Persistencia de sesión: ip_hash, hash consistente y sticky
ip_hash agrupa por /24
La guía de elhacker explica que ip_hash solo usa los tres primeros octetos de una IPv4. Lo comprobamos haciendo llegar peticiones desde 254 direcciones de cada red (con el módulo realip y la cabecera X-Forwarded-For):
Origen
Reparto con ip_hash
Reparto con hash $remote_addr consistent
10.0.0.1 a 10.0.0.254
254 a srv1
89 / 88 / 77
10.0.1.1 a 10.0.1.254
254 a srv2
90 / 86 / 78
192.168.50.1 a 192.168.50.254
254 a srv3
89 / 96 / 69
Toda una oficina detrás de la misma /24 acaba en el mismo servidor. Con muchas redes distintas el reparto se equilibra (334, 333 y 333 con mil redes), pero en una aplicación interna de empresa, donde la mayoría de usuarios sale por pocas direcciones, ip_hash puede cargar un servidor y dejar los otros vacíos. Si se necesita afinidad por IP, hash $remote_addr consistent usa la dirección completa.
Hash consistente: cuánto se mueve al cambiar el grupo
Para cachés y servicios con estado, lo que importa es cuántas claves cambian de servidor cuando se quita o se añade uno. Repartimos 3.000 URL distintas entre cuatro servidores y luego pasamos a tres y a cinco:
De 4 a 3 servidores
De 4 a 5 servidores
hash $request_uri
2.252 URL cambian (75,1 %)
2.383 (79,4 %)
hash $request_uri consistent
818 URL cambian (27,3 %)
623 (20,8 %)
Con el hash consistente, las 818 URL que cambiaron al quitar un servidor eran exactamente las que tenía el servidor retirado; ninguna otra se movió. Con el hash simple, tres de cada cuatro cambiaron de sitio. En una granja de cachés eso es la diferencia entre perder una cuarta parte de la caché y perderla casi entera.
sticky: ya no hace falta un módulo de terceros
La guía de elhacker propone instalar nginx-module-sticky desde un repositorio externo. Desde NGINX 1.29.6 (marzo de 2026) la directiva sticky es de código abierto, con sus tres modos (cookie, route y learn). Solo el parámetro sync, que replica las sesiones entre varios NGINX, sigue siendo de pago.
upstream app { server 10.0.0.11:8080 route=a; server 10.0.0.12:8080 route=b; server 10.0.0.13:8080 route=c; sticky cookie srv_id expires=1h path=/ httponly;}
En la prueba, cada cliente nuevo recibió una cookie distinta (srv_id=a, b o c) y sus diez peticiones siguientes fueron siempre al mismo servidor. Al parar srv2, un cliente con srv_id=b fue atendido por srv1 y recibió una cookie nueva, srv_id=a, sin ver ningún error.
Con route=, la cookie lleva una etiqueta corta en lugar del hash MD5 de la IP y el puerto, que es lo que pone por defecto. No da pistas sobre la red interna. Y a diferencia de ip_hash, distingue usuarios que salen por la misma IP.
En 1.26, route=a da invalid parameter y sticky no existe. En 1.30 y 1.31 funciona.
Keepalive con los backends: el cambio silencioso de 2026
Casi todas las guías, la de elhacker incluida, insisten en que para reutilizar conexiones con los backends hay que añadir keepalive, proxy_http_version 1.1 y vaciar la cabecera Connection. Desde NGINX 1.29.7 ya no hace falta: el registro de cambios dice que keepalive en el bloque upstream va activado por defecto (keepalive 32 local), que proxy_http_version vale 1.1 por defecto y que la cabecera Connection ya no se envía.
Lo medimos con la configuración mínima, sin tocar nada de eso, 3.000 peticiones y 10 clientes:
Versión
Conexiones TCP abiertas con los backends
Versión HTTP que ven los backends
NGINX 1.26 (Debian 13)
3.000, una por petición
HTTP/1.0 con Connection: close
NGINX 1.30.6 (estable)
10
HTTP/1.1
NGINX 1.31.8 (principal)
6
HTTP/1.1
En 1.26 sigues necesitando las tres líneas. En las versiones actuales sobran, aunque no hacen daño. Hay un efecto que conviene vigilar al actualizar: los backends que cerraban la conexión después de cada respuesta ahora reciben conexiones persistentes. Si un servidor de aplicación tiene un tiempo de espera de keepalive más corto que el de NGINX, pueden aparecer errores esporádicos de conexión cerrada. La solución suele ser que el backend aguante la conexión más tiempo que el balanceador.
Cuando un servidor falla
Aquí es donde vimos las diferencias más prácticas. NGINX libre solo tiene comprobaciones pasivas: no pregunta a los backends si están bien, se entera cuando una petición real falla.
Un backend que responde 503
Hicimos que srv2 devolviera 503 a todo, como una aplicación viva pero rota. Con la configuración por defecto, durante 15 segundos de tráfico 75 de 281 peticiones llegaron al cliente como error, hasta el último segundo de la prueba. El motivo: proxy_next_upstream vale por defecto error timeout, y un 503 no es ni una cosa ni otra. NGINX lo entrega tal cual y no marca el servidor como caído.
el resultado fue cero errores. NGINX reintenta en otro servidor y, como max_fails vale 1 y fail_timeout 10 segundos, saca a srv2 de la rotación y lo vuelve a probar cada 10 segundos con una petición real. En 33 segundos de tráfico continuo, srv2 recibió solo cuatro peticiones.
El POST no se reintenta, y está bien que no lo haga
Con la misma configuración, pero peticiones POST, el resultado cambia: 10 de 30 peticiones devolvieron 503, y srv2 siguió recibiendo una de cada tres. NGINX no reenvía a otro servidor un POST que ya ha llegado a un backend, porque no sabe si la operación se ha ejecutado. Con non_idempotent en proxy_next_upstream sí lo reenvía, y los errores bajaron a cero.
Activarlo es una decisión de la aplicación, no del balanceador. Si un POST crea un pedido o un cobro y el backend lo procesó antes de fallar, reintentarlo lo duplica. Solo tiene sentido cuando las operaciones son idempotentes o llevan una clave de idempotencia.
Proceso caído, máquina caída y cortafuegos que descarta: tres esperas distintas
Probamos tres formas de que un servidor desaparezca. Al cliente nunca le llegó un error, porque NGINX reintentó en otro servidor, pero la espera fue muy distinta:
Qué falla
Qué ve NGINX
Peor espera para el usuario
El proceso muere y el puerto queda cerrado
Conexión rechazada al instante
9 ms
La máquina desaparece de la red
Host is unreachable
3,1 s
Un cortafuegos descarta los paquetes
Nada, hasta agotar el tiempo
60 s
Lo mismo, con proxy_connect_timeout 2s
Tiempo agotado
2 s
El tercer caso es el más traicionero y el más habitual en producción: una VM colgada, un cambio de reglas o un enlace que se cae. proxy_connect_timeout vale 60 segundos por defecto, y con ese valor el primer usuario que cae en el servidor muerto espera un minuto. En una red de centro de datos, conectar con un backend sano lleva microsegundos o pocos milisegundos, así que un valor de 1 a 3 segundos es razonable. No hay que confundirlo con proxy_read_timeout, que es lo que se espera a que la aplicación responda y depende de lo que haga cada ruta.
max_conns no pone en cola: devuelve 502
La guía de elhacker dice que, al alcanzar max_conns, las peticiones se ponen en cola o van a otro servidor. En NGINX libre van a otro servidor si queda alguno con hueco; si no, el cliente recibe 502. La directiva queue, que es la que crea la cola, sigue siendo de pago: en 1.31.8 da unknown directive "queue".
Con dos servidores a max_conns=4, 20 clientes a la vez y peticiones de medio segundo, 92 de 100 peticiones recibieron 502 y el log dijo no live upstreams. Y aquí se ve lo de zone: con cuatro workers y sin zone, el límite se aplicó por worker, los backends llegaron a recibir hasta cuatro veces más conexiones de las configuradas y el número de 502 varió entre 30 y 44 de una pasada a otra. max_conns sin zone no limita lo que crees que limita.
Un nombre que no resuelve impide arrancar
Si un server del bloque upstream usa un nombre DNS que no resuelve en el momento de arrancar, NGINX no arranca:
nginx: [emerg] host not found in upstream "nuevo:8080"
Desde la versión 1.27.3, el parámetro resolve es libre:
upstream app { zone app 64k; resolver 10.0.0.2 valid=10s; server srv1.interno:8080; server nuevo.interno:8080 resolve;}
Con esto NGINX arrancó aunque nuevo no existía, dejó un aviso en el log y, al crear el contenedor, empezó a mandarle tráfico a los 5 segundos, lo que marca el valid=5s que usamos en la prueba. Es lo que hace falta en entornos donde los backends cambian de IP: contenedores, autoescalado o una VM que se mueve.
Lo que sigue siendo de pago en NGINX
Después de las aperturas de 2026, la lista se ha acortado bastante:
Función
NGINX libre
NGINX Plus
Round-robin, pesos, least_conn, ip_hash, hash, random
Sí
Sí
zone, max_conns, backup, down
Sí
Sí
resolve (DNS dinámico)
Sí, desde 1.27.3
Sí
sticky cookie, route y learn; drain
Sí, desde 1.29.6
Sí
Keepalive con los backends por defecto
Sí, desde 1.29.7
Sí
least_time
Sí, desde 1.31.0 (rama principal)
Sí
Health checks activos (health_check)
No
Sí
slow_start, queue
No
Sí
Sincronizar sesiones entre balanceadores (sticky … sync)
No
Sí
API para cambiar el grupo sin recargar y panel de estado
No
Sí
Lo más importante que falta son los health checks activos. Sin ellos, NGINX solo descubre que un servidor está mal cuando un usuario real choca con él. Con proxy_next_upstream bien configurado ese usuario no ve el error, pero sí la espera. Y en slow_start, que reintroduce un servidor recuperado poco a poco, en lugar de lanzarle de golpe su parte del tráfico.
Las alternativas de código abierto, con la misma prueba
Repetimos la prueba del servidor lento y la del backend que devuelve 503 con tres alternativas. Las tres resolvieron el reparto igual que NGINX con los métodos equivalentes. La diferencia está en los health checks.
NGINX 1.31.8
HAProxy 3.4.7
Traefik 3.7.19
Caddy 2.11.9
Licencia
BSD-2
GPL-2.0
MIT
Apache-2.0
Por conexiones: a srv3 / tiempo total
160 / 3,3 s
160 / 3,2 s
199 / 3,9 s (p2c)
160 / 3,3 s
Por tiempo de respuesta: a srv3 / p95
38 / 26 ms
No tiene un método equivalente
41 / 24 ms (leasttime)
No probado
Health checks activos
Solo en Plus
Sí
Sí
Sí
Panel o estadísticas
stub_status básico
Página de estadísticas completa
Panel web y API
API de administración
Configuración dinámica
Recarga
Runtime API y recarga sin cortes
Automática desde Docker, Kubernetes o fichero
API JSON
HAProxy: el especialista
HAProxy es el balanceador más veterano y el más completo como balanceador puro. Con balance leastconn repartió prácticamente igual que NGINX. La diferencia vino al romper srv2:
backend app
  balance leastconn
  option httpchk GET /health
  http-check expect status 200
  default-server inter 1s fall 3 rise 2
  retries 2
  option redispatch 1
  retry-on conn-failure empty-response response-timeout 503
  server srv1 10.0.0.11:8080 check
  server srv2 10.0.0.12:8080 check
  server srv3 10.0.0.13:8080 check
Solo con el health check activo (sin retry-on), HAProxy dio por caído a srv2 tras tres comprobaciones fallidas, a un segundo de intervalo. En esos dos segundos se colaron 9 errores; después, ninguno. Añadiendo retry-on 503 y redispatch, que es el equivalente al proxy_next_upstream de NGINX, los errores bajaron a cero.
Captura propia de la página de estadísticas de HAProxy 3.4.7 durante la prueba. srv2 aparece en rojo, caído por devolver 503 al health check. Las columnas Retr y Redis muestran las 13 peticiones que HAProxy reintentó y desvió a otro servidor sin que el cliente viera el fallo.
Esa página de estadísticas, que se activa con tres líneas, es una de las razones por las que tantos equipos de sistemas eligen HAProxy: lo que en NGINX libre hay que montar con logs y un sistema de métricas, aquí está a la vista. A cambio, HAProxy no sirve ficheros estáticos ni hace de servidor web, y no tiene un método equivalente a least_time.
Traefik: el que se configura solo
Traefik está pensado para entornos donde los servicios aparecen y desaparecen: lee la configuración de las etiquetas de Docker, de Kubernetes o de un fichero, y se reconfigura sin recargar. La versión 3.7 tiene cuatro estrategias: wrr (por defecto), p2c, hrw (hash por IP del cliente) y leasttime.
Con leasttime, srv3 recibió 41 peticiones de 3.000 y la p95 quedó en 24 ms, prácticamente lo mismo que least_time en NGINX. Con p2c (el poder de dos opciones) recibió 199.
Captura propia del panel de Traefik 3.7.19 durante la prueba, con el health check activo marcando srv2 como caído.
Es la opción natural si ya trabajas con contenedores y quieres que el balanceador descubra los servicios solo. Para una configuración estática con media docena de servidores, su modelo de routers, servicios y middlewares añade más piezas de las necesarias.
Caddy: el más sencillo
Caddy destaca por obtener y renovar certificados TLS solo y por una configuración muy corta. El balanceo completo, con health check activo, cabe en esto:
Con least_conn repartió exactamente igual que NGINX y HAProxy (160 peticiones a srv3), y el health check activo sacó a srv2 de la rotación cuando empezó a fallar. Tiene más políticas (random_choose, ip_hash, cookie, header…). Es una gran opción para equipos pequeños y despliegues con pocos servicios. Para tráfico muy alto o necesidades finas de balanceo, HAProxy y NGINX tienen más recorrido.
Otras opciones que conviene conocer
Envoy (1.40): el proxy de las mallas de servicios (service mesh), con health checks, reintentos, cortocircuito y una API para configurarlo en caliente. Es muy potente, pero se configura en YAML extenso o desde un plano de control, no a mano.
Angie (1.12): una bifurcación de NGINX creada por antiguos desarrolladores del proyecto, compatible con su configuración, que añade en la versión libre una API de estado con métricas por servidor del grupo y exportación a Prometheus, justo lo que NGINX libre no da. Ojo: los health checks activos (upstream_probe) son solo de su edición comercial, Angie PRO; no están en el código abierto.
Keepalived con LVS/IPVS: balanceo en capa 4 dentro del kernel de Linux, con una IP virtual que salta de máquina si una cae. No entiende HTTP, pero es muy rápido, y es la forma clásica de que el propio balanceador no sea un punto único de fallo: dos NGINX o dos HAProxy con una IP flotante gestionada por keepalived.
Qué configuración ponemos nosotros
Para una aplicación web con varios servidores detrás de NGINX, esta es nuestra base:
upstream app { zone app 128k; least_conn; # least_time header; si tienes 1.31 o posterior server 10.0.0.11:8080 max_fails=2 fail_timeout=10s; server 10.0.0.12:8080 max_fails=2 fail_timeout=10s; server 10.0.0.13:8080 max_fails=2 fail_timeout=10s; server 10.0.0.20:8080 backup; # en NGINX anterior a 1.29.7, añadir: keepalive 32;}server { listen 443 ssl; server_name app.ejemplo.com; location / { proxy_pass http://app; # en NGINX anterior a 1.29.7, añadir: proxy_http_version 1.1; proxy_set_header Connection ""; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header X-Forwarded-Proto $scheme; proxy_connect_timeout 2s; proxy_read_timeout 60s; proxy_next_upstream error timeout http_502 http_503 http_504; proxy_next_upstream_tries 2; proxy_next_upstream_timeout 10s; }}
Y unas cuantas reglas que salen de las pruebas:
Comprueba qué versión tienes antes de copiar una guía.nginx -v decide si tienes sticky, least_time o keepalive por defecto. Si te importan, el repositorio oficial de nginx.org tiene paquetes de la rama estable y de la principal para Debian, Ubuntu y RHEL.
Baja proxy_connect_timeout. Es la diferencia entre 60 segundos y 2 cuando una máquina se cuelga.
Pon los códigos 5xx en proxy_next_upstream, o un backend roto que responde 503 seguirá recibiendo su parte del tráfico.
No actives non_idempotent sin hablar con quien hizo la aplicación.
Usa zone siempre, y obligatoriamente con max_conns o resolve.
Si necesitas health checks activos y no quieres pagar NGINX Plus, pon HAProxy delante. Tener NGINX como servidor web y HAProxy como balanceador es una combinación muy habitual.
Duplica el balanceador. Un único NGINX delante de tres servidores no elimina el punto único de fallo; solo lo cambia de sitio. Dos balanceadores con keepalived y una IP flotante lo resuelven.
Si todos los servidores son iguales y las peticiones duran parecido, el round-robin vale. Si hay peticiones de duración muy distinta o servidores de capacidad diferente, least_conn. Con NGINX 1.31 o posterior, least_time header es el que mejor esquiva un servidor lento: en nuestra prueba bajó la p95 de 203 a 26 ms. Para cachés, hash con consistent.
¿NGINX libre tiene sesiones persistentes (sticky)?
Sí, desde la versión 1.29.6, de marzo de 2026. La directiva sticky con los modos cookie, route y learn ya no es exclusiva de NGINX Plus. Solo el parámetro sync, que comparte las sesiones entre varios balanceadores, sigue siendo de pago. Las versiones anteriores, como la 1.26 de Debian 13, no la tienen.
¿Hace falta configurar keepalive para los backends en NGINX?
En NGINX 1.29.7 o posterior, no: el keepalive con los backends va activado por defecto y proxy_http_version vale 1.1. En versiones anteriores sí hay que añadir keepalive, proxy_http_version 1.1 y vaciar la cabecera Connection. En nuestra prueba, NGINX 1.26 abrió 3.000 conexiones para 3.000 peticiones y la 1.31.8 solo seis.
¿NGINX libre detecta si un servidor está caído?
Solo de forma pasiva: lo marca como caído cuando falla una petición real, según max_fails y fail_timeout. Los health checks activos, que comprueban los servidores por su cuenta, siguen siendo de NGINX Plus. HAProxy, Traefik y Caddy los ofrecen gratis.
¿Es mejor NGINX o HAProxy para balancear carga?
Depende de lo que necesites. NGINX es servidor web, proxy y balanceador a la vez, y con las versiones de 2026 tiene sticky y least_time libres. HAProxy es solo balanceador, pero trae health checks activos, una página de estadísticas muy completa y una API para cambiar servidores en caliente. Es habitual usar los dos: HAProxy delante y NGINX sirviendo la aplicación.
Las cifras, mensajes y capturas salen de pruebas propias hechas el 18 de noviembre de 2026 en Docker 29.9, con las imágenes oficiales de NGINX 1.26, 1.30.6 y 1.31.8, HAProxy 3.4.7, Traefik 3.7.19 y Caddy 2.11.9, y tres servidores de prueba en Python 3.13. Son válidas para comparar métodos y productos entre sí, no como medida del rendimiento de ninguno en producción.
¿Le das una vuelta a tu infraestructura?
Si estás valorando cambiar algo, cuéntanos en qué punto estás. Te orientamos sin compromiso.
¿Te ha resultado útil? Compártelo o resúmelo con IA