Un vistazo en 30 segundos
- Para ejecutar un LLM en local, el orden de las preguntas es siempre el mismo: cuánta memoria pide el modelo, cuánto ancho de banda hace falta para que vaya fluido y, solo entonces, cuánto cuesta. Revista Cloud lo resume igual en su guía de compra de septiembre de 2026.
- Los precios de referencia en España, según esa guía: RTX 5090 (32 GB, 1.792 GB/s) desde unos 5.299 €; mini-PC con Ryzen AI Max+ 395 y 128 GB entre 3.500 y 3.900 €; DGX Spark (128 GB, 273 GB/s) a 4.800 €; Mac Studio M5 Max de 128 GB (614 GB/s) a 5.859 €; M5 Ultra de 256 GB (1,2 TB/s) a 10.999 €; RTX PRO 6000 (96 GB) en torno a 13.000 €, y B200 en la nube desde 4,7 €/hora.
- Una cuenta que lo ordena todo: generar un token obliga a leer los pesos activos del modelo. Ancho de banda ÷ gigas leídos por token = techo de tokens por segundo. Un 70B denso en 4 bits (unos 42 GB) da un techo de 6 tokens/s en un DGX Spark y de 43 en una RTX PRO 6000.
- Los modelos MoE han cambiado la compra. Qwen3.5-122B-A10B ocupa unos 73 GB pero solo lee unos 6 GB por token: en una máquina de 128 GB y 273 GB/s va siete veces más rápido que un 70B denso.
- Los modelos abiertos que merecen la pena en septiembre de 2026 son Qwen 3.5/3.6/3.8, Gemma 4, gpt-oss, Mistral Small 4, GLM-5.3, DeepSeek V4 y Kimi. Llama 4, de abril de 2025, sigue siendo lo último de Meta. Y la licencia importa: no todos son Apache 2.0.
- Una persona sola se apaña con Ollama, LM Studio o llama.cpp. Un equipo necesita vLLM o SGLang, y ahí cambia la cuenta de memoria: diez usuarios con 32.000 tokens de contexto en un 70B clásico suman unos 100 GiB solo de caché KV.
- El ordenador de la mesa deja de bastar cuando el modelo pasa a ser un servicio para varias personas, con datos sensibles, y tiene que estar disponible aunque alguien apague la oficina. Ese es el punto en que conviene llevarlo a un servidor con GPU en un centro de datos, propio o gestionado.
La pregunta «qué ordenador compro para ejecutar un LLM en local» tenía hace un año una respuesta casi automática: la tarjeta gráfica de NVIDIA con más memoria que te pudieras permitir. En septiembre de 2026 ya no es así. La memoria se ha encarecido tanto que una RTX 5090 cuesta en España más que un ordenador completo con cuatro veces su capacidad. Mientras tanto, AMD, NVIDIA, Apple y Lenovo venden máquinas de 128 GB o más de memoria unificada, y los modelos abiertos se han llenado de arquitecturas MoE que activan una fracción de sus parámetros en cada token.
Revista Cloud publicó hoy su guía de compra de septiembre, firmada por Silvia A. Feliz, con precios observados en España y Europa. Es el punto de partida de este artículo, pero aquí vamos a llevarla a donde nos toca: qué modelo cabe en cada máquina, qué velocidad cabe esperar, con qué software se sirve, qué dice la licencia y en qué momento el LLM deja de ser un experimento en el escritorio y pasa a ser infraestructura. Todas las cifras de hardware, versiones y modelos se han contrastado el 24 de septiembre con las fichas oficiales, Hugging Face y GitHub.
La regla que ordena la compra: memoria, ancho de banda y precio, en ese orden
La guía de Revista Cloud lo dice con una frase que conviene apuntar: primero hay que calcular cuánta memoria hace falta; después, cuánto ancho de banda se necesita; y solo entonces comparar precios. Vamos a ponerle números a cada paso.
Paso 1: cuánta memoria ocupan los pesos
Los pesos ocupan, en gigabytes, el número de parámetros en miles de millones multiplicado por los bytes de cada parámetro. Con las cuantizaciones habituales queda así:
| Precisión | Bytes por parámetro (aprox.) | Un 8B | Un 32B | Un 70B | Un 120B |
|---|
| FP16 / BF16 (sin cuantizar) | 2 | 16 GB | 64 GB | 140 GB | 240 GB |
| 8 bits (Q8_0, FP8) | ~1,06 | 8,5 GB | 34 GB | 74 GB | 127 GB |
| 4 bits (Q4_K_M, MXFP4, AWQ) | ~0,6 | 5 GB | 19 GB | 42 GB | 72 GB |
El 0,6 de los 4 bits no es un error: los formatos cuantizados guardan escalas por bloque y algunas capas se dejan con más precisión, así que en la práctica rondan los 4,5-5 bits por parámetro. En 4 bits la pérdida de calidad suele ser pequeña en modelos grandes y más visible en modelos pequeños. Por eso un 8B rara vez merece la pena por debajo de 8 bits y un 120B casi siempre se sirve en 4.
Paso 2: la memoria que nadie cuenta, la caché KV
Los pesos no son lo único que vive en memoria. Por cada token de contexto, el modelo guarda las claves y los valores de atención de cada capa (la caché KV), para no recalcularlos en cada paso. Se calcula a partir del config.json del modelo: 2 × capas × cabezas KV × dimensión de cabeza × bytes.
Con los ficheros de configuración reales de tres modelos, en FP16:
| Modelo | Arquitectura de atención | KV por token | 32.000 tokens | 128.000 tokens |
|---|
| Llama 3.3 70B (denso, dic. 2024) | 80 capas completas, 8 cabezas KV × 128 | 320 KiB | 10 GiB | 40 GiB |
| Qwen3-32B (denso) | 64 capas completas, 8 cabezas KV × 128 | 256 KiB | 8 GiB | 32 GiB |
| Qwen3.8-27B (denso, ago. 2026) | 16 capas completas + 48 de atención lineal, 4 cabezas KV × 256 | 64 KiB | 2 GiB | 8 GiB |
La última fila explica por qué las arquitecturas nuevas importan tanto como el tamaño. Qwen3.8 solo guarda caché KV en una de cada cuatro capas; las demás usan atención lineal con un estado de tamaño fijo. Gemma 4 hace algo parecido con ventanas deslizantes de 1.024 tokens en 50 de sus 60 capas. Con el mismo contexto, un modelo de 2026 puede necesitar cinco veces menos memoria de caché que uno de 2024, y eso decide cuántos usuarios caben a la vez en la misma máquina.
A pesos y caché hay que sumar el runtime, los búferes temporales y, en memoria unificada, lo que necesite el sistema operativo. Una regla prudente es dejar un 10-20 % libre. En los equipos Ryzen AI Max+ hay que recordar además que la GPU puede usar hasta 96 GB de los 128, según cómo se configure la memoria gráfica.
Paso 3: cuántos tokens por segundo, antes de medir nada
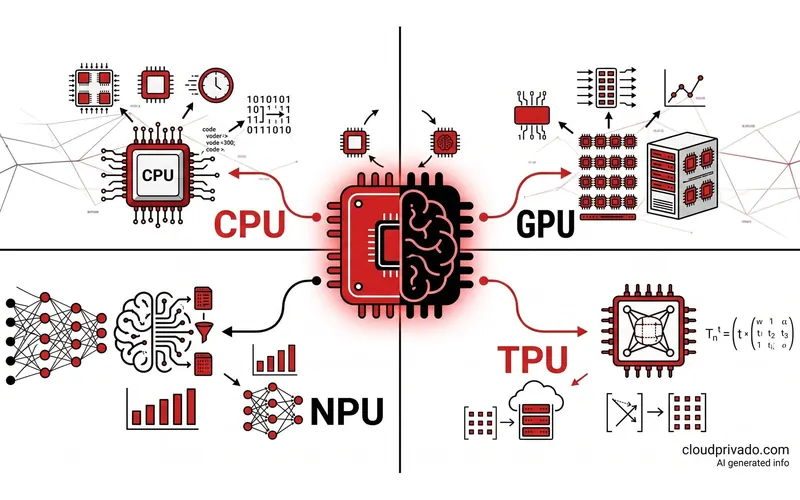
Para generar cada token, el modelo tiene que leer de memoria todos sus pesos activos. Por eso la velocidad de generación tiene un techo que se calcula dividiendo el ancho de banda de la memoria entre los gigas que se leen por token. Es la misma cuenta que hicimos en el artículo sobre CPU, GPU, TPU y NPU, y predice mucho mejor que los TFLOPS lo que vas a ver en pantalla.
En la práctica se alcanza entre un 50 y un 70 % de ese techo con un solo usuario. Es un techo teórico, pero sirve para descartar máquinas antes de comprarlas.
La tabla de compra, con los techos calculados
Esta es la tabla de hardware de la guía de Revista Cloud, con los datos técnicos contrastados en las fichas de NVIDIA, Apple y AMD. Hemos añadido tres columnas de cálculo propio: el techo de tokens por segundo para un denso de ~30B en 4 bits (unos 17 GB leídos por token), un 70B denso en 4 bits (~42 GB) y un MoE tipo Qwen3.5-122B-A10B en 4 bits (73 GB en total y unos 6 GB leídos por token).
| Equipo | Memoria | Ancho de banda | Precio orientativo | 30B denso Q4 | 70B denso Q4 | MoE 122B-A10B Q4 |
|---|
| RTX 5090 | 32 GB GDDR7 | 1.792 GB/s | desde ~5.299 € (solo la tarjeta) | ~105 tok/s | no cabe | no cabe |
| Ryzen AI Max+ 395 (Framework, GMKtec) | 128 GB LPDDR5X-8000 (hasta 96 GB para la GPU) | 256 GB/s | 3.500-3.900 € | ~15 tok/s | ~6 tok/s | ~43 tok/s |
| DGX Spark | 128 GB unificada | 273 GB/s | 4.800 € | ~16 tok/s | ~6,5 tok/s | ~45 tok/s |
| Mac Studio M5 Max | 128 GB unificada | 614 GB/s | 5.859 € | ~36 tok/s | ~15 tok/s | ~100 tok/s |
| Mac Studio M5 Ultra | 256 GB (hasta 512 GB) | 1,2 TB/s | 10.999 € (256 GB) | ~70 tok/s | ~29 tok/s | ~200 tok/s |
| Lenovo ThinkCentre X Ultra | hasta 128 GB LPDDR5X-8533 | ~273 GB/s (cálculo) | desde 3.100 € previsto (noviembre) | ~16 tok/s | ~6,5 tok/s | ~45 tok/s |
| RTX PRO 6000 Blackwell | 96 GB GDDR7 ECC | 1.792 GB/s | ~13.000 € o más | ~105 tok/s | ~43 tok/s | ~300 tok/s (justo de memoria) |
| H200 (servidor) | 141 GB HBM3e | 4,8 TB/s | servidor o alquiler | ~280 tok/s | ~114 tok/s | ~800 tok/s |
| B200 (servidor o nube) | 180 GB HBM3e | 8 TB/s | desde ~4,7 €/h en la nube | ~470 tok/s | ~190 tok/s | techo por cálculo, no por memoria |
Tres avisos para leer la tabla sin engañarse. El ancho de banda de los Ryzen AI Max+ no aparece en la guía y lo hemos calculado: bus de 256 bits a 8.000 MT/s dan 256 GB/s teóricos, y a 8.533 MT/s, unos 273. Los techos de H200 y B200 con un solo usuario están muy por encima de lo que se alcanza de verdad, porque a esas velocidades el límite pasa a ser el cálculo y la latencia del propio software. Y el precio de la RTX 5090 es el de la tarjeta sola: falta el ordenador que la aloja, con una fuente capaz de alimentar sus 575 W.
Lo que dice la tabla, en limpio:
- Si el modelo cabe en 32 GB, la RTX 5090 no tiene rival de escritorio. Por encima de 32 GB no es lenta: sencillamente no sirve, y repartir el modelo entre la VRAM y la RAM del sistema hunde la velocidad.
- Los mini-PC de 128 GB son la puerta de entrada barata a los modelos grandes, siempre que sean MoE. Con un 70B denso, 6 tokens por segundo se hacen largos para conversar.
- DGX Spark no es «una RTX 5090 con 128 GB», como advierte la propia guía. Rinde como un Ryzen AI Max+ y lo que aporta es CUDA: el mismo software que correrá después en el servidor.
- El M5 Max cuesta un 22 % más que el DGX Spark y ofrece 2,2 veces su ancho de banda. El M5 Ultra es la única máquina de escritorio que mueve un 70B denso a una velocidad cómoda y la que abre la puerta a los modelos de 200.000-400.000 millones de parámetros. Qué supone ejecutar vLLM sobre un Mac en lugar de sobre CUDA lo contamos en otro artículo.
- La RTX PRO 6000 es la opción CUDA con mucha memoria sin salir del puesto de trabajo, pero a 13.000 € la tarjeta ya es una compra de empresa. NVIDIA subió su precio en Estados Unidos a 16.000 dólares en agosto, según recoge la guía.
Qué modelo ejecutar: los abiertos que importan en septiembre de 2026
Con el hardware claro, falta la otra mitad: qué modelo cargar. Esta es una selección de los modelos de pesos abiertos vigentes, con la fecha en que se publicaron en Hugging Face, la licencia que figura en su ficha y la memoria aproximada de los pesos en 4 bits. Para los MoE, lo que decide la velocidad es la columna de parámetros activos.
| Modelo | Publicado | Parámetros totales | Activos por token | Contexto | Licencia | Pesos en 4 bits (aprox.) | Dónde cabe |
|---|
| Qwen3.5-9B | feb. 2026 | 9B | denso | 262K | Apache 2.0 | ~5,5 GB (mejor en 8 bits: ~10 GB) | Cualquier portátil moderno |
| gpt-oss-20b | ago. 2025 | 21B | 3,6B | 131K | Apache 2.0 | ~16 GB (MXFP4 de origen) | GPU de 16-24 GB, Mac de 32 GB |
| Qwen3.8-27B | ago. 2026 | 27B | denso | 262K | Apache 2.0 | ~16 GB | RTX 5090, Mac de 36-48 GB |
| Gemma 4 31B | mar. 2026 | 30,7B | denso | 256K | Apache 2.0 | ~18 GB | RTX 5090, Mac de 48 GB |
| Qwen3.6-35B-A3B | abr. 2026 | 35B | 3B | 262K | Apache 2.0 | ~21 GB | RTX 5090; muy rápido en memoria unificada |
| gpt-oss-120b | ago. 2025 | 117B | 5,1B | 131K | Apache 2.0 | cabe en una GPU de 80 GB (MXFP4) | 128 GB unificada, RTX PRO 6000, H100 |
| Mistral Small 4 | ene. 2026 | 119B | 6,5B | 256K | Apache 2.0 | ~71 GB | 128 GB unificada, RTX PRO 6000 |
| Qwen3.5-122B-A10B | feb. 2026 | 122B | 10B | 262K | Apache 2.0 | ~73 GB | 128 GB unificada, RTX PRO 6000 |
| Mistral Medium 3.5 | mar. 2026 | 128B | denso | 256K | MIT modificada (excluye a empresas que facturan más de 20 M$ al mes) | ~77 GB | 128 GB, pero lento: es denso |
| GLM-5.3-Flash | ago. 2026 | 320B | 18B | 1M | MIT | ~190 GB | M5 Ultra 256 GB, servidor con 2 H200 |
| Qwen3.5-397B-A17B | feb. 2026 | 397B | 17B | 262K | Apache 2.0 | ~240 GB | M5 Ultra 512 GB, servidor con 2-4 H200 |
| Mistral Large 3 | nov. 2025 | 675B | 41B | 256K | Apache 2.0 | ~400 GB | Servidor de 4 H200 u 8 GPU |
| Kimi K2.6 | abr. 2026 | 1T | 32B | 256K | MIT modificada | ~600 GB | Nodo de 8 GPU |
| DeepSeek-V4-Pro | ago. 2026 | 1,6T | 49B | 1M | MIT | ~960 GB | Nodo de 8 B200 o varios nodos |
Faltan en la lista modelos que siguen en uso, como Llama 4 Scout y Maverick (109B y 400B, abril de 2025, con la licencia comunitaria de Meta y acceso restringido en Hugging Face) o los gigantes Qwen3.8-2.4T y Kimi K3, de 2,4 y 2,8 billones de parámetros, que no son un tema de hardware local. Meta no ha publicado un LLM abierto nuevo desde Llama 4.
En una empresa, la columna de la licencia pesa tanto como la de memoria. Apache 2.0 y MIT permiten el uso comercial sin letra pequeña: Qwen 3.5, 3.6 y 3.8-27B, Gemma 4, gpt-oss, Mistral Small 4 y Large 3, DeepSeek V4 y GLM-5.3-Flash. Otras licencias añaden condiciones que conviene leer antes de montar un servicio encima:
- Mistral Medium 3.5 usa una MIT modificada que excluye a las empresas que facturan más de 20 millones de dólares al mes.
- Qwen3.8-Flash-Next lleva la Qwen Community License, que exige otra licencia para ofrecerlo comercialmente como servicio (Model as a Service).
- Kimi K3, GLM-5.3 y Qwen3.8-2.4T tienen licencias propias con umbrales de ingresos a partir de los cuales hay que negociar con el fabricante.
- Llama 4 se descarga aceptando la licencia comunitaria de Meta, con su propia política de uso.
Para un uso interno en una pyme, casi ninguno de estos umbrales se alcanza. Pero si el modelo va a estar detrás de un producto que se vende, hay que saberlo antes de elegir el hardware y no después.
Qué modelo para qué memoria, en una línea
- 16-24 GB: gpt-oss-20b o Qwen3.5-9B en 8 bits. Sirven para asistentes, resúmenes y clasificación.
- 32 GB (RTX 5090): Qwen3.8-27B, Gemma 4 31B o Qwen3.6-35B-A3B en 4 bits, con contexto de sobra gracias a sus cachés pequeñas.
- 96-128 GB: gpt-oss-120b, Mistral Small 4 o Qwen3.5-122B-A10B. Es el salto de calidad más rentable de 2026, porque son MoE y van rápidos incluso con 256-273 GB/s.
- 256-512 GB: GLM-5.3-Flash y Qwen3.5-397B-A17B. Aquí solo llegan el M5 Ultra o un servidor.
- Más de 512 GB: Mistral Large 3, Kimi, DeepSeek V4. Ya no es hardware de escritorio. Es un nodo de GPU en un centro de datos.
Cómo ejecutarlo: el software según quién lo vaya a usar
La otra decisión que casi nadie separa de la compra es el runtime. No es lo mismo un modelo que usa una persona desde su portátil que una API interna para cincuenta empleados.
| Runtime | Última versión (24-sep-2026) | Licencia | Para qué | Dónde brilla |
|---|
| llama.cpp | v0.5.0 (23-sep) | MIT | Inferencia con GGUF, llama-server con API compatible con OpenAI | CPU, CUDA, ROCm, Metal y Vulkan: corre en todo |
| Ollama | v0.34.4 (23-sep) | MIT | Descargar y ejecutar modelos con un comando | Puesto de trabajo, pruebas, desarrolladores |
| LM Studio | — | Propietaria, gratuita | Interfaz gráfica sobre llama.cpp y MLX | Usuarios no técnicos |
| MLX-LM | v0.31.3 (abr.) | MIT | Inferencia y LoRA en Apple Silicon | Mac con memoria unificada |
| vLLM | v0.30.0 (22-sep) | Apache 2.0 | Servidor multiusuario: batching continuo, caché KV paginada | GPU NVIDIA y AMD en servidor |
| SGLang | v0.5.20 (18-sep) | Apache 2.0 | Servidor multiusuario con reutilización agresiva de prefijos | Agentes y RAG con prompts repetidos |
| Unsloth | 2026.9.11 (23-sep) | Apache 2.0 | Ajuste fino: LoRA, QLoRA, SFT, GRPO, DPO | NVIDIA, AMD, Apple, CPU |
Para una persona, empezar es cuestión de un minuto:
# Ollama: descarga y ejecuta gpt-oss-20b
ollama run gpt-oss:20b

# llama.cpp: el mismo modelo en GGUF, con API compatible con OpenAI en el puerto 8080
llama-server -hf ggml-org/gpt-oss-20b-GGUF
Para un equipo, el salto es a vLLM o SGLang en un servidor con GPU:
# vLLM: gpt-oss-120b servido para varios usuarios en una GPU de 80 GB o más
vllm serve openai/gpt-oss-120b
Los tres exponen /v1/chat/completions, así que las aplicaciones (un chat interno, un asistente de código, un flujo de RAG sobre la documentación de la empresa) no cambian al pasar del portátil al servidor. Lo que cambia es lo que pasa por debajo cuando llegan diez peticiones a la vez: Ollama y llama.cpp están pensados para pocas conversaciones simultáneas; vLLM y SGLang, para mantener la GPU ocupada con muchas.
Cuando el modelo deja de ser tuyo y pasa a ser del equipo
Aquí está la parte que no sale en las guías de compra, y es la que más nos preguntan. Un LLM en el escritorio de una persona es un experimento. El mismo LLM usado por un departamento es un servicio, y un servicio tiene otras cuentas.
La memoria se multiplica por usuario. Recupera la tabla de la caché KV. Diez personas trabajando a la vez con 32.000 tokens de contexto sobre Llama 3.3 70B son unos 100 GiB solo de caché, más 42 GB de pesos: no cabe en ninguna máquina de 128 GB. Con Qwen3.8-27B, las mismas diez personas suman unos 20 GiB de caché y 16 GB de pesos, y caben en una sola GPU de 48 GB. Elegir el modelo es elegir la infraestructura, y conviene hacerlo en ese orden.
La disponibilidad deja de ser opcional. Un Mac Studio debajo de una mesa no tiene fuente redundante, se reinicia con las actualizaciones y se apaga cuando alguien desenchufa la regleta. Si el equipo depende del asistente para trabajar, eso es una caída de servicio.
La potencia y el calor llegan antes de lo que parece. Una RTX 5090 declara 575 W; una RTX PRO 6000, 600 W; una H200, hasta 700 W. Dos tarjetas de ese nivel en una oficina ya piden un circuito eléctrico propio y una climatización que no suele haber. En un centro de datos, en cambio, es un rack normal.
Los datos son la razón de todo esto. Si se ejecuta un modelo en local es, muchas veces, para que los contratos, los historiales o el código no salgan de la empresa. Ese argumento se cae si la máquina está en un despacho sin control de acceso, sin copias y sin registro de quién la usa. Los prompts de un asistente interno contienen exactamente los datos que se querían proteger. Por qué importa además dónde está físicamente el servidor lo explicamos en soberanía del dato y CLOUD Act.
Dónde tiene sentido cada opción
| Escenario | Qué encaja | Por qué |
|---|
| Una persona, modelos de hasta ~30B | RTX 5090 o Mac con 48-64 GB | Máxima velocidad por euro si el modelo cabe |
| Una a tres personas, MoE de ~120B | Ryzen AI Max+ 395, DGX Spark o M5 Max de 128 GB | 128 GB por 3.500-5.900 € y velocidad suficiente con MoE |
| Prototipo que luego irá a producción en NVIDIA | DGX Spark | El mismo CUDA, el mismo vLLM y los mismos contenedores que en el servidor |
| Departamento o empresa (10-100 personas), datos sensibles | Servidor con GPU dedicada en un centro de datos, con vLLM o SGLang | Concurrencia, disponibilidad, control de acceso y copias |
| Modelos de 400B a 1,6T | Nodo de 4-8 GPU H200 o B200 | No hay otra forma de reunir 400-1.000 GB de memoria rápida |
| Ajuste fino o entrenamiento puntual | GPU por horas | Pagas solo las horas de trabajo |
| Ya tienes el Mac Studio o el DGX Spark | Housing en un centro de datos | Mismo equipo, con energía redundante, refrigeración y red |
La última fila tiene más recorrido del que parece: nada impide llevar un Mac Studio o un DGX Spark a un rack. Lo contamos a propósito de los Mac que ya están en los centros de datos, y es una forma razonable de dar el paso sin cambiar de hardware.
Comprar, alquilar o alojar: la cuenta en euros
La guía de Revista Cloud da el dato clave: una B200 en la nube se encuentra desde unos 4,7 €/hora en proveedores europeos, y otras ofertas se mueven entre 5,4 y 6 €. Un trabajo de cuatro horas cuesta unos 20 €. La misma GPU encendida todo el mes, a 5 €/hora, supera los 3.600 €.
Pongamos al lado lo que cuesta cada máquina de escritorio amortizada a tres años, sin contar electricidad ni el ordenador que necesita una tarjeta suelta:
| Equipo | Precio | Coste mensual a 36 meses | Horas de B200 (a 4,7 €/h) que paga ese mes |
|---|
| Ryzen AI Max+ 395, 128 GB | ~3.500 € | ~97 € | ~21 h |
| DGX Spark | 4.800 € | ~133 € | ~28 h |
| RTX 5090 (solo la tarjeta) | ~5.299 € | ~147 € | ~31 h |
| Mac Studio M5 Max, 128 GB | 5.859 € | ~163 € | ~35 h |
| Mac Studio M5 Ultra, 256 GB | 10.999 € | ~306 € | ~65 h |
| RTX PRO 6000 (solo la tarjeta) | ~13.000 € | ~361 € | ~77 h |
La lectura es la de siempre y la hicimos con más detalle al comparar bare metal con GPU frente al hiperescalar: el alquiler por horas gana cuando el uso es esporádico, y el hardware dedicado gana en cuanto el uso es sostenido. Un asistente interno que se usa ocho horas al día, cinco días a la semana, son unas 170 horas al mes: con esa carga, cualquier fila de la tabla sale más barata que alquilar. Un ajuste fino al trimestre, no.
La estrategia que propone la guía nos parece la correcta: preparar datos, código y parámetros en local, y alquilar la GPU grande solo durante el trabajo pesado. Nosotros añadiríamos un tercer escalón: cuando el modelo ya es un servicio del que depende la empresa, sacarlo de la oficina y ponerlo en un servidor dedicado, con la GPU entera para ti y los datos en un centro de datos que sabes dónde está. Y comprarlo o contratarlo antes de que suba otra vez: la memoria de servidor también se ha encarecido, no solo la de las tarjetas.
Entrenar ya no es solo cosa de NVIDIA, pero casi
La guía corrige una idea extendida. Unsloth funciona en macOS, Windows y Linux, con NVIDIA, AMD, Intel, CPU y Vulkan, y admite LoRA, QLoRA, SFT, RL, GRPO y DPO. MLX hace LoRA y QLoRA en Apple Silicon, y Apple mostró en la WWDC26 un entrenamiento distribuido de Qwen 3.5 de 9.000 millones de parámetros que pasaba de unos 180 tokens por segundo en un equipo a unos 600 en un clúster. AMD, por su parte, ha mejorado el soporte de ROCm en los Ryzen AI Max+.
Aun así, para ajustar modelos medianos con rapidez y con todas las herramientas disponibles, CUDA sigue siendo el camino con menos sorpresas. En infraestructura propia, lo práctico es separar dos cosas: la inferencia de todos los días, que puede vivir en el hardware que mejor encaje por memoria y coste, y el ajuste fino puntual, que puede hacerse en una GPU alquilada o en un servidor dedicado en el que se hace passthrough de la tarjeta a una máquina virtual para ese trabajo.
Lo que nos llevamos
La conclusión de Revista Cloud es que ya no existe una única máquina que tenga sentido para todos los LLM locales, y es cierto. Pero la decisión se simplifica mucho si se hace en el orden correcto: primero el modelo (y su licencia), después la memoria que pide con el contexto y los usuarios reales, después el ancho de banda que da la velocidad aceptable, y al final el precio.
Si el modelo cabe en 32 GB, una RTX 5090 es imbatible. Si es un MoE de unos 120.000 millones de parámetros, una máquina de 128 GB de memoria unificada hace el trabajo por la mitad de dinero. Si es un 70B denso o algo mayor y tiene que ir rápido, el M5 Ultra o una RTX PRO 6000. Y si lo van a usar decenas de personas con datos que no pueden salir de la empresa, deja de ser una compra de escritorio y pasa a ser infraestructura.
Si estás en ese punto, cuéntanos qué modelo quieres servir y para cuántos usuarios y lo dimensionamos contigo: memoria, GPU, red y dónde tienen que estar los datos. Podemos hacerlo con servidores GPU dedicados, sobre bare metal o alojando en un centro de datos el equipo que ya tienes.
Preguntas frecuentes
¿Qué hardware necesito para ejecutar un LLM en local?
Depende del modelo. Como referencia: 16-24 GB de memoria para modelos de hasta unos 20.000 millones de parámetros, 32 GB para modelos de 27-35B en 4 bits, 128 GB para MoE de unos 120B como gpt-oss-120b o Qwen3.5-122B-A10B, y 256-512 GB para modelos de 300-400B. Además de la capacidad, importa el ancho de banda de esa memoria, que es lo que marca los tokens por segundo.
¿Cuánta memoria necesita un modelo de 70B?
Unos 140 GB en FP16, unos 74 GB en 8 bits y unos 42 GB en 4 bits, solo los pesos. A eso hay que sumar la caché KV: en Llama 3.3 70B son unos 10 GiB por cada conversación de 32.000 tokens. Por eso un 70B en 4 bits no cabe en una RTX 5090 de 32 GB y sí en una máquina de 128 GB, aunque en esta última va lento si el ancho de banda ronda los 256-273 GB/s.
¿Qué es mejor para LLM, DGX Spark, Mac Studio o un Ryzen AI Max+?
Los tres ofrecen 128 GB. El Ryzen AI Max+ 395 es el más barato (3.500-3.900 €) y ofrece 256 GB/s. DGX Spark cuesta 4.800 € y ofrece 273 GB/s, pero trae CUDA, lo que lo hace ideal si después vas a desplegar en servidores NVIDIA. El Mac Studio M5 Max cuesta 5.859 € y ofrece 614 GB/s, más del doble de velocidad de generación con el mismo modelo.
¿Ollama o vLLM?
Ollama (o llama.cpp, sobre el que se apoya) para una persona o un equipo muy pequeño: se instala en minutos y corre en cualquier hardware. vLLM, o SGLang, cuando varias personas usan el modelo a la vez: su batching continuo y la caché KV paginada aprovechan la GPU con decenas de peticiones simultáneas. Los tres exponen una API compatible con OpenAI, así que se puede empezar con uno y pasar al otro sin tocar las aplicaciones.
¿Qué LLM de código abierto puedo usar en una empresa sin problemas de licencia?
Los publicados con Apache 2.0 o MIT: Qwen 3.5, 3.6 y 3.8-27B, Gemma 4, gpt-oss, Mistral Small 4 y Large 3, DeepSeek V4 y GLM-5.3-Flash, entre otros. Mistral Medium 3.5, Qwen3.8-Flash-Next, Kimi y Llama 4 tienen licencias propias con condiciones sobre ingresos o sobre ofrecerlos como servicio, que hay que leer antes de usarlos en un producto comercial.
¿Sale más barato comprar hardware o alquilar GPU en la nube para un LLM?
Depende de las horas de uso. Una B200 en la nube cuesta desde unos 4,7 €/hora, y a 5 €/hora encendida todo el mes supera los 3.600 €. Un DGX Spark amortizado a tres años equivale a unas 28 horas de B200 al mes. Para uso esporádico (un ajuste fino puntual), alquilar; para un servicio que se usa a diario, hardware propio o dedicado.
¿Cuándo conviene llevar el LLM local a un servidor en un centro de datos?
Cuando lo usan varias personas a la vez, cuando procesa datos sensibles que necesitan control de acceso y copias, o cuando tiene que estar disponible sin depender de la oficina. También cuando el consumo pasa de uno o dos kilovatios: dos GPU de 575-600 W ya no son razonables en un despacho.
Fuentes
- Revista Cloud, Qué comprar para ejecutar LLM en local en septiembre de 2026 (Silvia A. Feliz, 24 de septiembre de 2026): artículo de partida. Precios de referencia en España y Europa, tabla de compra, precios de B200 en la nube y datos de Unsloth, MLX y la WWDC26.
- NVIDIA, DGX Spark: 128 GB de memoria unificada, 273 GB/s y 1 PFLOP en FP4 (con dispersión).
- NVIDIA, GeForce RTX 5090: 32 GB GDDR7, 1.792 GB/s, 21.760 núcleos CUDA y 575 W.
- NVIDIA, RTX PRO 6000 Blackwell: 96 GB GDDR7 con ECC, 1.792 GB/s y 600 W.
- NVIDIA, DGX B200, H200 y H100: memoria y ancho de banda por GPU (180 GB y 8 TB/s; 141 GB y 4,8 TB/s; 80 GB y 3,35 TB/s).
- Apple, especificaciones del Mac Studio: M5 Max hasta 128 GB y 614 GB/s; M5 Ultra hasta 512 GB y 1,2 TB/s.
- Fichas de los modelos en Hugging Face, consultadas el 24 de septiembre de 2026: gpt-oss-120b (incluida la frase sobre MXFP4 y la GPU de 80 GB), gpt-oss-20b, Qwen3.5-9B, Qwen3.8-27B, Gemma 4 31B, Qwen3.6-35B-A3B, Mistral Small 4, Qwen3.5-122B-A10B, Mistral Medium 3.5, GLM-5.3-Flash, Qwen3.5-397B-A17B, Mistral Large 3, Kimi K2.6, DeepSeek-V4-Pro y Qwen3.8-Flash-Next.
- Cálculo de la caché KV hecho a partir de los
config.json de Llama 3.3 70B, Qwen3-32B y Qwen3.8-27B (capas, cabezas KV, dimensión de cabeza y tipo de atención por capa).
- Versiones del software comprobadas en GitHub el 24 de septiembre de 2026: llama.cpp, Ollama, vLLM, SGLang, MLX-LM y Unsloth.
- El ancho de banda de los Ryzen AI Max+ es cálculo propio a partir del bus de 256 bits y la velocidad de la memoria (8.000 y 8.533 MT/s). Los techos de tokens por segundo y los costes mensuales también son cálculos propios con las cifras de esta página.