Un vistazo en 30 segundos
- vLLM es, antes que nada, un servidor: planificador de peticiones, batching continuo y caché KV paginada. Sobre NVIDIA y AMD, el cálculo lo hacen CUDA o ROCm y sus kernels.
- vLLM-Metal es el plugin oficial para Apple Silicon. Conserva el servidor, el planificador y el gestor de bloques de vLLM, pero cambia el motor de cálculo por MLX y aporta sus propios kernels Metal para la atención.
- vllm-mlx es otro proyecto, sin relación con el equipo de vLLM, que construye desde cero un servidor sobre MLX con APIs compatibles con OpenAI y con Anthropic.
- Que los tres respondan en
/v1/chat/completions no significa que hagan lo mismo por debajo. Los kernels, la memoria y el formato del modelo cuantizado son distintos.
- vLLM-Metal va rápido: v0.1.0 en abril de 2026, v0.29.0 el 11 de septiembre, con soporte para los aceleradores NAX del M5 en el prefill y carga de checkpoints AWQ y GGUF.
- La pregunta útil es para qué hardware está hecho cada uno y qué carga vas a servir, un modelo grande para pocos usuarios o una API para cientos, no cuál es mejor.
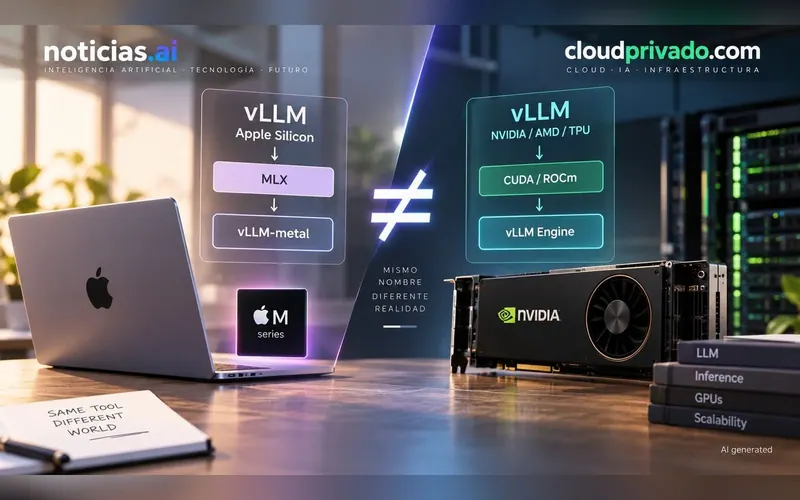
vLLM se ha convertido en el nombre que sale cuando alguien quiere servir un modelo de lenguaje en serio. Y como sale tanto, se ha empezado a usar como si fuera una sola cosa que funciona igual en cualquier máquina. No lo es. En NVIDIA, en AMD o en Intel, vLLM se apoya en un backend y en unos kernels específicos para cada acelerador, y en Apple Silicon la historia es todavía más distinta: vLLM-Metal usa MLX como motor de cálculo, mientras que vllm-mlx, que no tiene nada que ver con el proyecto vLLM, monta su propio servidor directamente sobre MLX. El objetivo es parecido. Las capas que lo hacen posible, no.
La distinción importa ahora que los Mac con Apple Silicon se usan cada vez más para ejecutar modelos en local, y no solo en el portátil de un desarrollador. Un Mac Studio y un servidor con una GPU NVIDIA pueden cargar el mismo modelo y exponer la misma API compatible con OpenAI, y desde la aplicación parecen intercambiables. El camino que recorre cada token hasta convertirse en respuesta no lo es.
El propio proyecto lo deja claro. La documentación de instalación de vLLM separa las plataformas GPU en NVIDIA CUDA, AMD ROCm, Intel XPU y Apple Silicon a través de vLLM-Metal, con las CPU x86, ARM, Apple e IBM Z en otro bloque, y aparte mantiene un sistema de plugins de hardware que viven fuera del repositorio principal. vLLM-Metal es uno de esos plugins.
vLLM es un servidor, no un ejecutor de modelos
Lo que diferencia a vLLM de un programa que carga un modelo y genera texto es que intenta resolver el problema de servir muchas peticiones a la vez sin desperdiciar el acelerador.
Sus piezas son conocidas: un planificador que decide qué peticiones entran en cada paso, batching continuo para que una petición nueva no espere a que terminen las anteriores, y la gestión paginada de la caché KV, la memoria donde el modelo guarda lo que ya ha procesado de cada conversación para no recalcularlo con cada token. Esa idea, tratar la caché KV como si fuera memoria virtual con páginas, es la que dio nombre al proyecto (PagedAttention) y la razón de que aproveche mejor la memoria que las implementaciones anteriores.
Todo eso importa cuando varias personas usan el mismo modelo al mismo tiempo. El objetivo no es que una petición suelta termine rápido, sino que el hardware esté ocupado mientras siguen llegando solicitudes.
En una GPU NVIDIA, ese trabajo descansa sobre una cadena larga de software: CUDA, kernels de atención especializados, operaciones fusionadas, gestión de memoria y las características concretas de cada generación de tarjeta. Cuando alguien dice «vLLM sobre NVIDIA», buena parte del rendimiento viene de lo que hay debajo del servidor, no del servidor. En AMD pasa lo mismo con ROCm.
Aquí entra vLLM-Metal, un plugin mantenido por la comunidad dentro de la organización de vLLM en GitHub, que permite ejecutar vLLM en Macs con Apple Silicon usando MLX como backend de cálculo principal. MLX es el framework de arrays que Apple publicó a finales de 2023 pensado para su propio silicio, con kernels Metal y memoria unificada como punto de partida.
El README describe la arquitectura sin rodeos. El vLLM de arriba pone el servidor de API, el planificador y el gestor de bloques paginados; mlx_lm pone las capas del modelo, y vLLM-Metal se queda con la ruta de atención, que es la parte que sabe de peticiones y de bloques: el kernel paginado de longitud variable, el prefill sobre las unidades NAX del M5 y la decodificación especulativa.
Apple Silicon
   ↓
MLX (kernels Metal, memoria unificada)
   ↓
mlx_lm (capas del modelo)  +  vLLM-Metal (atención paginada, prefill, especulativo)
   ↓
vLLM (API, planificador, gestor de bloques KV)
La idea que se repite en los diagramas de «Apple Silicon → MLX + PyTorch → vLLM-Metal» es correcta con un matiz: el proyecto dice que unifica MLX y PyTorch bajo una misma ruta de compilación, pero el cálculo lo hace MLX, y PyTorch queda como capa de compatibilidad con lo que vLLM espera encontrar.
Y el ritmo es alto. Las releases cuentan la historia:
| Versión | Fecha | Qué trajo |
|---|
| v0.1.0 | 8 de abril de 2026 | Caché KV paginada y atención paginada en Metal, base del batching continuo. 148 PR. |
| v0.2.0 | 4 de junio de 2026 | Kernel Metal unificado de longitud variable como backend de atención por defecto: 83× menos tiempo hasta el primer token y 3,6× de rendimiento respecto a v0.1.0. TurboQuant para comprimir la caché KV a 2-8 bits. |
| v0.28.0 | 1 de septiembre de 2026 | Salto de numeración para ir a la par con vLLM 0.28.0. 152 PR de 28 personas. Instalación sin compilador, prefill sobre las unidades NAX del M5, decodificación especulativa, carga de GGUF y servicio distribuido con Ray. |
| v0.29.0 | 11 de septiembre de 2026 | Sigue a vLLM 0.29.0. MLX 0.32.1, más familias híbridas (LFM2, Nemotron-H), embeddings y correcciones del especulativo. |
Lo del NAX merece una línea. Los chips M5 llevan aceleradores para operaciones de tensor dentro de cada núcleo de GPU, y vLLM-Metal los usa para el prefill de la atención (la fase en la que el modelo procesa el prompt entero antes de generar el primer token) en las variantes MHA, GQA y MQA. El proyecto midió entre un 21 y un 41 % menos de tiempo hasta el primer token y entre un 27 y un 33 % más de rendimiento total en las cargas donde la atención pesaba de verdad. Es código que solo tiene sentido en ese chip. No hay un equivalente en CUDA porque no hay nada que equivalga.
Eso cambia cómo hay que leer Apple Silicon como plataforma de inferencia. No es una versión lenta de un vLLM pensado para NVIDIA que alguien ha conseguido compilar en macOS. Hay kernels escritos para ese hardware y una matriz propia de modelos que distingue entre soportado, experimental, no probado y no soportado.
Los requisitos también son concretos: macOS 15 o posterior, Python 3.12 nativo arm64, y se instala con Homebrew o con un script que descarga wheels precompilados. Desde v0.28.0 no hace falta Xcode ni compilador de Metal para instalar la versión estable.
Y luego está vllm-mlx, que toma otro camino
vllm-mlx es un proyecto distinto y de otro autor, con licencia Apache 2.0, que se instala con pip install vllm-mlx y se define como «un servidor de inferencia al estilo de vLLM para Macs con Apple Silicon». No reutiliza el servidor de vLLM. Construye el suyo alrededor de MLX y le añade lo que un servidor de producción necesita: batching continuo, caché KV paginada, caché de prefijos, un segundo nivel de caché en SSD para agentes con contextos largos, y dos APIs en el mismo proceso, la de OpenAI en /v1/* y la de Anthropic en /v1/messages. Lo segundo hace que se pueda apuntar Claude Code a un modelo local cambiando una variable de entorno.
Además sirve modelos de visión, audio de entrada, transcripción con Whisper y síntesis de voz, y trae parsers para llamadas a herramientas de una docena larga de familias de modelos. Publica sus propias cifras en un M4 Max con 128 GB, en decodificación con una sola secuencia: 418 tokens por segundo con Qwen3-0.6B en 8 bits, 206 con Llama 3.2 3B en 4 bits y 128 con Qwen3-30B-A3B en 4 bits.
Aquí aparece una diferencia de arquitectura que conviene tener presente. vLLM-Metal reutiliza componentes del proyecto vLLM y los conecta con MLX; vllm-mlx escribe su propio servidor sobre el ecosistema MLX. Los dos pueden dar una experiencia parecida al usuario:
POST /v1/chat/completions
        ↓
      modelo
        ↓
     respuesta
Pero por debajo pueden estar haciendo cosas distintas, igual que dos bases de datos que hablan el mismo protocolo. Desde la aplicación da lo mismo. Cuando se llega a la memoria, a los kernels, a la caché o a la planificación de peticiones, las diferencias aparecen enseguida.
El cuello de botella real suele estar en los kernels
Un modelo de lenguaje no ejecuta una operación, ejecuta miles por token, y el rendimiento final depende de que cada una tenga una implementación eficiente para el hardware concreto. En NVIDIA existe un ecosistema de kernels CUDA con más de una década de trabajo detrás; en Apple Silicon, MLX aporta sus primitivas y kernels Metal, y vLLM-Metal escribe los que faltan para la parte que le toca.
Por eso una comparación del tipo «el mismo modelo va a X tokens por segundo en un Mac y a Y en una NVIDIA» vale poco si no se especifica versión del motor, cuantización, modelo, longitud de contexto, número de peticiones simultáneas y hardware. Dos sistemas pueden ejecutar el mismo modelo y estar haciendo un trabajo bastante diferente por debajo. Con vLLM-Metal, además, la cifra de junio y la de septiembre pueden diferir en un orden de magnitud sin que el modelo haya cambiado.
La madurez de los kernels también pone límites. La matriz de modelos de vLLM-Metal marca como soportadas las familias densas habituales (Qwen3, Llama 3, Mistral 7B, Gemma 3 y 4, Phi) y como experimentales las híbridas con Mamba-2 o las MoE grandes, avisa de que la atención con ventana deslizante no está optimizada del todo y de que la caché de prefijos está desactivada en algunos híbridos. Nada de eso es un defecto raro, es lo normal en un backend que tiene cinco meses de releases públicas.
La cuantización introduce otra diferencia
Hay un detalle que suele quedar escondido cuando se comparan motores: cómo se representa el modelo cuantizado, y ahí cada ecosistema tiene lo suyo.
En el de Apple, mlx-lm convierte modelos de Hugging Face a su formato y ofrece varios modos de cuantización. El script de conversión admite affine, mxfp4, nvfp4 y mxfp8, y el cargador sabe transformar pesos empaquetados en AWQ y GPTQ al formato de MLX, siempre que sean de 4 bits. Decir que «MLX solo acepta su propia cuantización» sería demasiado tajante.
Pero sí hay una consecuencia práctica: no todos los checkpoints cuantizados que circulan son intercambiables entre motores. vLLM-Metal lo documenta con detalle. Los checkpoints AWQ de Hugging Face entran a través de la conversión de mlx-lm, con una comprobación previa que rechaza las variantes que no soporta (gemv, otros anchos de bit, grupos distintos de 128). Los GGUF se sirven directamente con los pesos en formato MLX, pero solo Q8_0, Q4_0 y Q4_1, y solo para modelos densos de las familias Qwen2, Qwen3, Llama y Mistral. Los K-quants que llenan Hugging Face, los MoE, los híbridos y los GGUF fragmentados se rechazan con un error claro. Hay un dato al margen que dice mucho de cómo se organiza vLLM: en la versión 0.24 el soporte de GGUF salió del núcleo a un plugin solo para CUDA y ROCm, y vLLM-Metal tuvo que hacer el suyo.
Todo esto importa cuando se monta infraestructura alrededor de un modelo. Elegir un runtime no es solo elegir qué API usar; condiciona qué modelos, checkpoints y formatos van a ser cómodos de desplegar y cuáles van a obligar a reconvertir.
Apple Silicon cambia también la conversación sobre la memoria
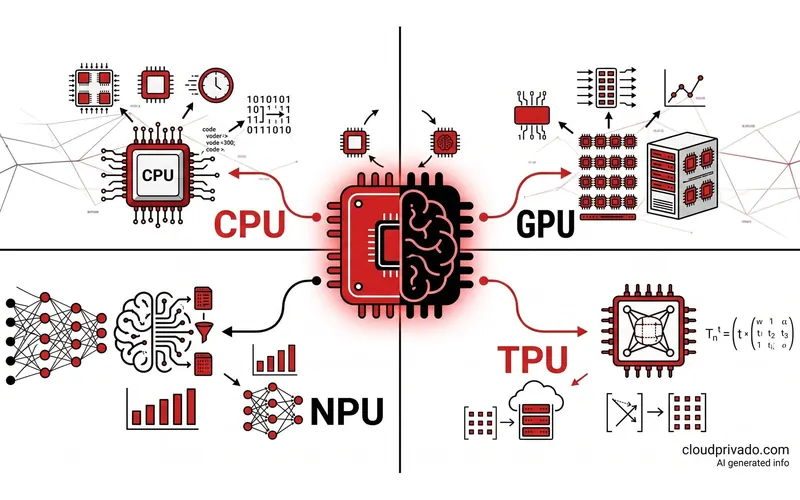
La otra gran diferencia está en la arquitectura de memoria. Una GPU NVIDIA trabaja con su propia memoria de vídeo, rápida y limitada; Apple Silicon usa memoria unificada que comparten CPU y GPU, mucho más grande y bastante más lenta. Ya lo contamos en el post sobre CPU, GPU, TPU y NPU: en inferencia, generar un token obliga a leer los pesos del modelo enteros, así que el techo de tokens por segundo lo marca el ancho de banda dividido entre el tamaño del modelo.
Con números de este mes: un Mac Studio con M5 Ultra llega a 512 GB de memoria unificada a 1,2 TB/s; una NVIDIA H200 tiene 141 GB de HBM3e a 4,8 TB/s. La H200 es cuatro veces más rápida moviendo datos. El Mac tiene 3,6 veces más sitio. Un modelo de 400.000 millones de parámetros en 8 bits cabe en el Mac y no cabe en la H200 sin repartirlo entre varias tarjetas; y una vez cargado en los dos, la H200 lo sirve mucho más rápido y a muchos más usuarios a la vez.
Por eso MLX es interesante: está diseñado desde el principio para esa combinación de mucha memoria y ancho de banda moderado, con los arrays viviendo en un pool común sin copias entre CPU y GPU. Y por eso vLLM-Metal tiene sentido: combina esa ejecución con un servidor que ya sabe lo que hace falta en producción. Lo que ninguno de los dos hace es convertir un Mac en un sustituto de un servidor GPU para una API con cientos de usuarios simultáneos. Son cosas distintas.
No hay ganador universal: depende de dónde se ejecuta
La comparación útil no es «vLLM contra MLX». Se parece más a esto:
| Entorno | Capa de cálculo | Capa de servicio | Quién lo mantiene |
|---|
| NVIDIA | CUDA y kernels específicos | vLLM | Proyecto vLLM |
| AMD | ROCm y kernels específicos | vLLM | Proyecto vLLM |
| Apple Silicon | MLX + kernels Metal propios | vLLM + plugin vLLM-Metal | Comunidad, dentro de la organización vLLM |
| Apple Silicon | MLX | vllm-mlx (servidor propio) | Proyecto independiente |
La tabla simplifica una arquitectura con más piezas, pero deja ver lo importante: el nombre del servidor no determina el rendimiento; el hardware y el backend deciden buena parte de lo que ocurre debajo.
Y esto se aplica a la decisión de compra. Para una aplicación local con una o pocas peticiones, la prioridad es cargar un modelo grande con una cantidad razonable de memoria y consumir poco, y ahí un Mac mini o un Mac Studio con MLX, con o sin vLLM-Metal delante, tiene mucho sentido. Para una API con cientos de usuarios simultáneos, la prioridad cambia hacia batching, utilización del acelerador, latencia y escalado horizontal, y ahí el vLLM de siempre sobre GPU profesionales sigue siendo la respuesta. En medio hay casos, como un asistente interno que consultan cincuenta personas, donde hay que hacer las cuentas, y las cuentas son las de la memoria, no las de los teraflops.
Lo que nos llevamos
Dos motores pueden tener exactamente el mismo objetivo, servir un LLM, y estar resolviendo problemas técnicos muy distintos. Antes de preguntar cuál es mejor conviene preguntar para qué hardware está construido, qué backend usa, qué kernels tiene disponibles, cómo gestiona la memoria, qué formatos de modelo admite y, sobre todo, qué carga se quiere ejecutar.
vLLM-Metal es la respuesta más seria hasta ahora a «quiero vLLM en un Mac», y en cinco meses ha pasado de un kernel de atención de primera generación a exprimir los aceleradores del M5. vllm-mlx es la respuesta a «quiero un servidor completo sobre MLX sin pasar por vLLM». Ninguno de los dos es vLLM sobre NVIDIA, y no pasa nada, siempre que no se compare tokens por segundo sin decir en qué máquina y con qué versión.
Si estás dimensionando inferencia y dudas entre un puñado de Macs con memoria unificada, un servidor con una o dos GPU o algo en medio, cuéntanos qué modelo, cuántos usuarios y qué latencia necesitas. Con esas tres cifras se responde casi siempre.
Preguntas frecuentes
¿vLLM funciona en un Mac con Apple Silicon?
Sí, a través del plugin vLLM-Metal, que la documentación de vLLM lista como la vía oficial para Apple Silicon. Necesita macOS 15 o posterior y Python 3.12 nativo, y desde la versión 0.28.0 se instala con Homebrew o con un script sin necesidad de compilador.
No. Comparte con vLLM el servidor de API, el planificador y el gestor de bloques de la caché KV, pero el cálculo lo hace MLX con kernels Metal escritos para Apple Silicon, incluidos los que aprovechan los aceleradores NAX del M5. En NVIDIA, vLLM usa CUDA y su ecosistema de kernels.
vllm-mlx es un proyecto independiente, sin relación con la organización vLLM, que construye desde cero un servidor de inferencia sobre MLX con batching continuo, caché KV paginada y APIs compatibles con OpenAI y con Anthropic. vLLM-Metal reutiliza el servidor de vLLM; vllm-mlx trae el suyo.
¿Puedo usar en un Mac los modelos cuantizados que ya tengo en GGUF o AWQ?
Depende del formato. mlx-lm convierte AWQ y GPTQ de 4 bits a su representación, y vLLM-Metal sirve GGUF en Q8_0, Q4_0 y Q4_1 para modelos densos de las familias Qwen, Llama y Mistral. Los K-quants, los MoE y los GGUF fragmentados no están soportados y hay que reconvertir el modelo.
¿Un Mac Studio sustituye a un servidor con GPU NVIDIA para servir un LLM?
Para un modelo grande con pocos usuarios, puede: 512 GB de memoria unificada permiten cargar modelos que no caben en una sola GPU. Para una API con muchos usuarios simultáneos, no: el ancho de banda de memoria de una GPU de centro de datos es varias veces mayor y el ecosistema de kernels está mucho más maduro.
Fuentes
- vLLM, documentación de instalación — las plataformas soportadas (NVIDIA CUDA, AMD ROCm, Intel XPU, Apple Silicon vía vLLM-Metal) y el sistema de plugins de hardware.
- Repositorio
vllm-project/vllm-metal en GitHub — arquitectura (vLLM + mlx_lm + vLLM-Metal), requisitos, instalación y noticias sobre las unidades NAX del M5.
- Releases de vLLM-Metal — v0.1.0 (8-abr-2026), v0.2.0 (4-jun), v0.28.0 (1-sep) y v0.29.0 (11-sep), con las cifras de rendimiento y las novedades de cada una.
- Matriz de modelos compatibles de vLLM-Metal — familias soportadas y experimentales, carga de AWQ y GGUF y sus límites.
- Documentación de vLLM-Metal.
- Repositorio
waybarrios/vllm-mlx en GitHub — funciones, APIs y cifras de rendimiento en un M4 Max.
- MLX-LM,
convert.py — modos de cuantización affine, mxfp4, nvfp4 y mxfp8.
- MLX-LM,
utils.py — conversión de pesos AWQ y GPTQ de 4 bits al formato de MLX.
- Noticias.ai, vLLM en un Mac no funciona igual que vLLM sobre una GPU NVIDIA (17 de septiembre de 2026) — origen de la imagen que ilustra este artículo.